Mai multe resurse, aceeași cauză
De ce adăugarea de CPU, RAM sau IOPS rezolvă rareori un database mission-critical care încetinește — și ce să verifici înainte să semnezi oferta.
Oferta de pe masă #
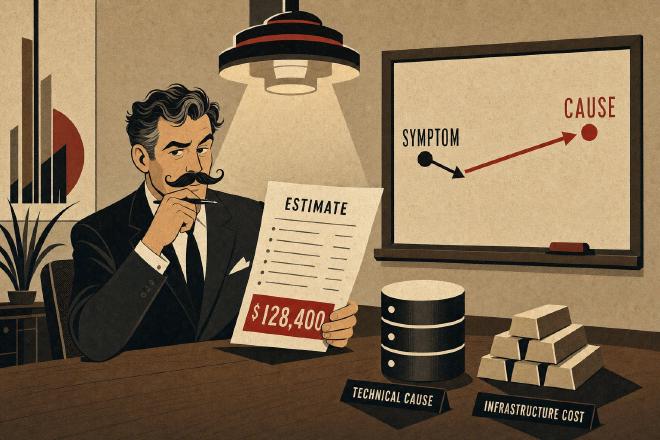
Există un moment care se repetă aproape identic în bănci, asigurări, utilități și telecomunicații. Un CIO — sau un CTO, sau un Head of Data Platform — se uită la o ofertă pentru un upgrade de infrastructură. Poate fi un nou Exadata, un PDB mai mare pe OCI, o migrare la o instanță cloud cu mai mulți IOPS garantați, RAM suplimentar pe un server fizic care nu mai făcea față.
Cifra din dreapta jos oscilează între câteva sute de mii și câteva milioane de euro. Justificarea scrisă două pagini mai sus sună rezonabil: sistemul suferă, echipa spune că e nevoie de mai multă capacitate, vendor-ul confirmă, SLA-urile cu clienții enterprise sunt pe punctul de a fi depășite. Board-ul vrea un răspuns rapid, CFO-ul vrea să știe până când se semnează.
Reacția instinctivă, în acel moment, este să aprobi.
Este instinctivă dintr-un motiv ușor de înțeles: adăugarea de resurse este decizia cea mai ușor de explicat în douăzeci de secunde în comitetul de direcție. Este măsurabilă (mai mulți giga, mai multe core-uri, mai mulți IOPS), este comparabilă (vendor-ul îți trimite lista de prețuri), este trasabilă (la sfârșitul anului CFO-ul știe exact ce s-a cheltuit). Dă impresia precisă că s-a făcut ceva.
Și în o parte din cazuri — probabil mai puțin decât se crede, dar nu zero — chiar funcționează. Dacă sistemul era cu adevărat subdimensionat față de sarcină, mai multă capacitate rezolvă. Pe hârtie este alegerea rațională.
Problema este ce se întâmplă în celelalte cazuri.
Ce se întâmplă când nu era cauza reală #
Un database care încetinește este, practic întotdeauna, un simptom. Simptomul apare într-un punct precis: o interogare nocturnă care depășește fereastra de execuție, un batch analitic care durează de trei ori mai mult, o aplicație front-end care răspunde greu în orele de vârf, un incident sporadic care se rezolvă singur după zece minute. Cauza reală, într-un sistem stratificat în zece sau douăzeci de ani, se află aproape întotdeauna un nivel mai adânc față de punctul în care apare simptomul.
Poate fi un plan de execuție degradat din cauza unor statistici învechite. Poate fi un model de date care a crescut mai repede decât a fost proiectat — o tabelă ajunsă de la 200 de milioane la 2 miliarde de rânduri cu aceiași indecși de acum zece ani. Poate fi o configurație de storage schimbată cu șase luni în urmă care a mutat un fișier pe un tier mai lent. Poate fi o interogare nouă, introdusă de o aplicație venită anul trecut, care scanează o tabelă mare la fiecare trei minute fără ca nimeni să fi observat. Poate fi o configurație RAC care, sub un anumit nivel de concurență, declanșează wait event-uri transversale care nu apar în monitorizarea zilnică.
În toate aceste cazuri, adăugarea de resurse produce un efect măsurabil și temporar. Sistemul, cu mai mult CPU sau mai mulți IOPS, reușește să mascheze blocajul timp de câteva săptămâni, uneori câteva luni. Apoi blocajul se mută. Planul degradat nu s-a schimbat, tabela crește în continuare, interogarea prost proiectată continuă să ruleze — și între timp sarcina a crescut și ea, cum crește întotdeauna în sistemele reale. Simptomul revine, într-un punct ușor diferit, adesea agravat de faptul că acum infrastructura este mai costisitoare de menținut.
Când se întâmplă asta, conversația internă devine o a doua problemă. Pentru că CIO-ul care tocmai a semnat acea ofertă trebuie să explice board-ului că problema pe care upgrade-ul trebuia să o rezolve a revenit. Și board-ul — în mod legitim — pune întrebarea pe care CIO-ul o teme cel mai mult: „și acum? Un alt upgrade?"
Un caz concret, cu cifrele alături #
Un exemplu concret, cu sector și ordine de mărime (cifre reale, client anonimizat). Un batch analitic critic într-un context telco, cu Oracle pe OCI și Autonomous Database, necesita patru ore în fiecare noapte. În cei trei ani anteriori, răspunsul fusese: mai mult CPU, mai mulți IOPS, mai multă memorie SGA. La fiecare rundă, batch-ul scădea cu douăzeci de minute câteva săptămâni, apoi revenea la pragul de patru ore. O analiză cross-layer — planuri de execuție, wait event-uri istorice în AWR, corelație cu creșterea tabelelor sursă, revizuirea join-urilor celor mai costisitoare, rescrierea țintită a trei pași din PL/SQL — a adus timpul de batch sub treizeci de minute. Resursele de infrastructură au rămas cele de la care s-a pornit.
Într-un alt context, un Data Warehouse pe patru țări europene cu peste 60.000 de linii de PL/SQL, pattern-ul era similar: fereastra de ingestie nocturnă se lungea de la un trimestru la altul, iar cererea recurentă era mai multă mașinărie. După o intervenție pe modelul de date, pe indecși și pe reorganizarea unor tabele de staging, ingestia zilnică completă a revenit sub două ore — fără să se atingă partea de infrastructură.
Ideea nu este că hardware-ul nu este niciodată necesar. Ideea este că, atunci când cauza reală stă în software, în model sau în plan, hardware-ul cumpără timp. Timpul este util — uneori este indispensabil pentru a ajunge până la weekendul următor de mentenanță — dar este timp, nu soluție. Și când îl cumperi crezând că ai rezolvat, al doilea incident vine în cel mai prost moment, cu întrebarea: „după primul, ce am făcut?"
Rândul 330 e încă acolo #
Există o imagine pe care o folosesc des, și pe care cei care au început să programeze acum patruzeci de ani o înțeleg fără explicații. Commodore 64, când găsea o eroare, afișa un mesaj politicos: ?SYNTAX ERROR IN 340. Te duceai să verifici rândul 340 și era perfect. Cauza era în 330 — un punct și virgulă care cu câteva minute înainte devenise două puncte. (Am povestit pe larg acea experiență — și cum s-a transformat de-a lungul anilor în meseria de azi — în Il dottore tutto pazzo: un Commodore 64, una porta chiusa e il mestiere di capire.)
Copiii de atunci au învățat din acea experiență un principiu care astăzi rămâne valabil pe sistemele enterprise: locul în care calculatorul se plânge nu este aproape niciodată locul în care se află eroarea. Adăugarea de hardware acolo unde sistemul se plânge este echivalentul adult al modificării rândului 340. Programul continuă să nu funcționeze, pentru că rândul 330 încă așteaptă.
În database-urile mission-critical mecanismul este același. Se schimbă doar dimensiunile. Și costul greșelii.
Întrebările care preced semnătura #
Niciuna dintre aceste întrebări nu vrea să convingă pe cineva să nu semneze un upgrade. În unele cazuri, repet, upgrade-ul este răspunsul corect și trebuie făcut. Întrebările servesc la a decide de la caz la caz dacă este cu adevărat așa, înainte ca oferta să devină comandă.
1. Ce s-a schimbat în zilele sau săptămânile care au precedat primul simptom? Un sistem care a funcționat ani de zile și acum suferă are, aproape întotdeauna, un eveniment declanșator. Un patch, o versiune nouă a aplicației, o statistică recalculată, o tabelă crescută peste un prag, o schimbare de configurație storage, un modul nou care a început să apeleze database-ul diferit. Dacă timeline-ul acelui ce s-a schimbat nu este reconstruit în mod credibil, upgrade-ul cumpără timp pe o cauză încă necunoscută.
2. Ce dovadă tehnică susține ipoteza că e nevoie de mai multă capacitate? Un AWR cu dovezi clare că wait event-urile dominante sunt CPU-bound sau I/O-bound susține un upgrade. Un ASH care arată sesiuni blocate pe lock-uri aplicative, sau un plan de execuție degradat care face un full scan pe o tabelă indexabilă, indică o altă direcție. Diferența se citește în date, nu în intuiții.
3. Cine, în echipă sau alături de echipă, privește sistemul în ansamblu? DBA-ul vede database-ul, dezvoltatorul vede aplicația, administratorul de sistem vede infrastructura, echipa de rețea vede rețeaua. Fiecare vede corect bucata lui. Cauza reală, când este transversală, stă în intersecție — și niciunul dintre aceste roluri, prin definiție, nu are vizibilitate completă asupra intersecției. Întrebarea „cine citește sistemul în ansamblu?" nu este retorică: dacă răspunsul este „nimeni în mod structurat", upgrade-ul decide înainte de a fi înțeles.
4. Dacă upgrade-ul ar funcționa doar trei luni, care ar fi planul B? Este întrebarea pe care cei mai experimentați CIO o pun ultima. Dacă răspunsul este „vom face altul", strategia este clară și riscul merită asumat. Dacă răspunsul este „nu ne-am gândit la asta", merită să ne oprim un moment.
Comparația pe care CFO-ul o înțelege în treizeci de secunde #
Un Health Check structurat — cinci zile de analiză cross-layer, un raport cu timeline, dovezi și roadmap cu priorități — are un cost cu un ordin de mărime mai mic decât oferta medie de upgrade de infrastructură enterprise (orientativ €8K pentru Health Check față de €300K–€500K pentru un upgrade Exadata de dimensiune medie — cifre de referință DE VERIFICAT față de listinele specifice ale clientului).
Logica pentru un CFO este liniară: înainte să semnezi o cheltuială cu șase zerouri, o a doua opinie independentă costă o fracțiune din ofertă și reduce probabilitatea de a semna de două ori pentru aceeași problemă. Nu este o reducere a cheltuielii de infrastructură — este o asigurare că, atunci când semnătura vine, vine pe decizia corectă.
Valoarea pentru CIO este și mai directă: aduce board-ului o decizie apărabilă. „Am comandat o analiză independentă, am comparat concluziile ei cu propunerea vendor-ului, alegerea finală este coerentă cu ambele" este o frază care închide subiectul în trei rânduri de proces-verbal. „Am semnat pentru că vendor-ul o sugera" deschide un alt tip de conversație — cea pe care CIO-ul preferă să n-o aibă șase luni mai târziu, dacă problema revine.
O întrebare de dus cu tine #
Nu există un principiu universal despre upgrade-ul de infrastructură. Există contexte în care este alegerea corectă și trebuie făcut fără ezitare; există altele în care este timp cumpărat scump. Diferența nu stă în tehnologie, nici în vendor. Stă în calitatea diagnosticului care precede semnătura.
Dacă o ofertă importantă se află pe masa ta în aceste săptămâni, există o întrebare care merită pusă înainte de aprobare:
„Analiza care susține această cheltuială distinge în mod credibil între cauza reală a încetinirii și punctul în care încetinirea se manifestă — sau presupune că acestea coincid?"
Dacă răspunsul are vreo ezitare, rândul 330 ar putea fi încă acolo.