- Ivan Luminaria/
- Database Strategy/
- Leadership tehnic și proiecte/
- AI-ul arată simptomul. Boardul cere cauza./
AI-ul arată simptomul. Boardul cere cauza.
AI-ul arată simptomul. Boardul cere cauza. #
Ce face, cu adevărat, observability modernă — și ce mai e nevoie, când întrebarea vine de la etajul de sus.
Întrebarea de luni dimineața #
Există o întrebare pe care orice CIO o cunoaște bine, și care apare aproape întotdeauna în cele douăzeci și patru de ore de după un incident serios. O pune boardul, o pune CFO-ul, uneori o pune directorul general în coridor. Sună cam așa, cu mici variații: «dar nu luaserăm Datadog anul trecut? Nu reînnoiserăm Dynatrace? Nu activaserăm Ops Insights pe OCI? Atunci cum e posibil că nu ne-a avertizat?».
Răspunsul sincer e incomod, pentru că cere să spui două lucruri în același timp. Primul: instrumentul a funcționat. Graficul era acolo, metricile erau înregistrate, alertele erau configurate. Al doilea: instrumentul nu a înțeles ce se întâmpla, pentru că a înțelege nu era treaba lui. Treaba lui era să arate. A arătat — regulat, cu precizie. Nimeni din echipă nu a citit ce arăta ca semnal al unui lanț care se compunea.
Cel care prezintă bilanțul boardului, în acel moment, are două drumuri. Poate lăsa ca narațiunea să devină «instrumentul ne-a dezamăgit» — și să se întoarcă la procurement cu cererea unui alt instrument, poate mai scump, poate cu mai multă inteligență artificială declarată în materialul comercial. Sau poate să-și ia o după-amiază pentru a explica boardului ce face și ce nu face, cu adevărat, observability modernă de care s-a dotat. Al doilea drum e mai obositor, dar îi restituie CIO-ului controlul narațiunii — ceea ce boardul caută cu adevărat când pune acea întrebare.
Ce arată un instrument, ce reconstruiește o persoană #
Datadog, Dynatrace, Grafana, Splunk, New Relic, OCI Ops Insights, Oracle Cloud Observability sunt — fiecare cu calitatea sa proprie, care e reală — extraordinari colectori de semnale. Înregistrează zeci de mii de metrici pe secundă, corelează serii temporale, aplică modele statistice care identifică anomalii cu un nivel de precizie de neconceput acum zece ani. În multe scenarii valoarea pe care o adaugă e foarte mare: alerte operaționale care sosesc înainte de o saturare previzibilă, dashboard-uri care consolidează într-o singură vedere ceea ce înainte necesita opt console separate, baseline-uri care recunosc comportamentul normal al unui sistem și semnalează când iese din el.
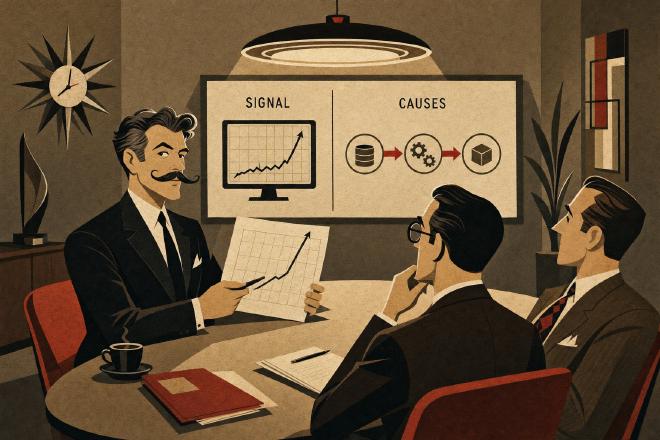
Punctul în care aceste instrumente încetează să înlocuiască o persoană nu e o limită de calitate a produsului — e o limită structurală a tipului de informație pe care o returnează. Un grafic arată că CPU-ul a crescut, că latența discului a crescut, că un wait event a devenit dominant, că o interogare și-a schimbat planul de execuție. Un model AIOps, în cazurile mai sofisticate, semnalează că trei sau patru dintre aceste fenomene sunt corelate în timp. Corelația nu e lanțul cauzal. Lanțul cauzal e o poveste: un pachet de statistici a fost recalculat pe 14 septembrie la 02:17 de job-ul nocturn, noul plan de execuție pentru interogarea X a început să scaneze complet un tabel crescut la 1,8 miliarde de rânduri în cele trei luni anterioare, contența pe enqueue application lock a apărut când noua versiune aplicativă — lansată pe 16 — a început să apeleze acea interogare la fiecare douăzeci de secunde în loc de la fiecare cinci minute, spike-ul de CPU pe care monitoring-ul l-a semnalat pe 17 e consecința a trei evenimente pe care monitoring-ul nu le-a corelat între ele pentru că nimeni nu îi ceruse să caute acest tip de poveste.
Această poveste nu o spune un instrument. O reconstruiește o persoană care știe ce să caute — pentru că a citit mii de lanțuri similare, pe sisteme similare, în zece sau douăzeci de ani de meserie. Instrumentul îi furnizează datele de pornire. Fără instrument, reconstrucția ar fi mai lentă. Fără persoană, nu ar exista.
Un caz, și graficul alăturat #
Un context telco italian, Oracle pe OCI, batch analitic critic care alimentează o serie de dashboard-uri comerciale. Observability era modernă, investiția recentă, AIOps-ul activ. Timp de șase săptămâni consecutive, batch-ul — care istoric se finaliza în două ore și jumătate — a început să depășească mai întâi spre patru ore, apoi spre cinci. Instrumentul semnala regulat: anomalie pe CPU wait, creștere I/O read, creștere a latenței de stocare pe tier 1. Trei anomalii distincte, corelate temporal, niciuna identificată ca primă cauză — pentru că niciuna nu era.
Echipa a petrecut trei săptămâni urmărind fiecare anomalie separat. Mai mult CPU la nod, verificarea stocării cu furnizorul cloud, optimizarea sesiunilor concurente. Fiecare intervenție a produs o îmbunătățire de cincisprezece sau douăzeci de minute pe timpul de batch, apoi curba a revenit în creștere. Niciunul dintre cele trei intervenții nu era greșit în sine: fiecare răspundea uneia dintre anomaliile semnalate de instrument. Niciunul nu era răspunsul, pentru că răspunsul nu se afla în niciuna dintre cele trei anomalii luate separat.
O analiză cross-layer de cinci zile a reconstituit lanțul. Un plan de execuție degradat cu trei luni înainte din cauza unei statistici care pierduse reprezentativitate pe un tabel crescut cu un ordin de mărime; o modificare de configurare pe PGA făcută într-un ticket urgent în mai și niciodată documentată; o interogare nouă introdusă de o aplicație front-end la începutul lui iulie, care deschidea o concurență neașteptată pe o structură de lock internă a bazei de date. Trei evenimente distanțate în timp, documentate în trei sisteme diferite (repository-ul DBA, wiki-ul infrastructural, release manager-ul aplicativ), nicio corelare automată posibilă între ele pentru un instrument de observability — pentru că erau evenimente de natură, perioadă și sistem diferite.
Batch-ul, după revizuirea comună a planului, a indexării țintite și a rollback-ului modificării PGA, a revenit stabil sub treizeci de minute. Instrumentul de observability, din acel moment, a devenit mult mai util — pentru că echipa a început să citească graficele lui cu o hartă în minte. (Cifrele — 800 de milioane de înregistrări/zi, SLA sub 500 ms pe serviciul downstream — rămân cele declarate în alte intervenții pe contexte similare; detaliul operațional al acestui caz specific e anonimizat din motive de confidențialitate contractuală.)
Electrocardiograma e un dat, nu un diagnostic #
Există o imagine care ajută, mai ales cu un board care nu e tehnic dar a văzut cel puțin o dată o cameră de urgențe. O electrocardiogramă înregistrează cu precizie ritmul inimii. Recunoaște aritmii, semnalează extrasistole, arată frecvența instantanee cu un nivel de detaliu pe care un medic de acum cincizeci de ani l-ar fi considerat science fiction. E un instrument diagnostic excepțional.
Nu vede carotida obstruată. Nu vede un embol care se formează într-o venă profundă. Nu vede un anevrism asimptomatic. Pacientul poate avea un ECG impecabil și un accident vascular cerebral treizeci de secunde mai târziu. Nu e un defect al ECG-ului — e natura ECG-ului: înregistrează o funcție precisă, nu toate funcțiile pacientului. Medicul știe asta, și folosește ECG-ul ca unul dintre examene, niciodată ca diagnostic. Anamneza, examenul obiectiv, alte examene țintite pe baza suspiciunii clinice, istoricul pacientului de-a lungul anilor: toate acestea împreună reconstruiesc tabloul.
Un sistem mission-critical are aceeași natură ca un pacient complex. Observability modernă e ECG-ul — excepțional pentru ce face, orb pentru ce nu vede. AIOps-ul e un ECG care evidențiază automat aritmiile, util. Diagnosticul rămâne un act uman, și rămâne astfel nu din nostalgie față de trecut, ci din structura problemei în sine: lanțul cauzal al unui sistem stratificat în douăzeci de ani necesită să ții împreună repository-uri DBA, change log-uri infrastructurale, release note aplicative, urme de sistem de operare, pattern-uri de încărcare, modificări ale modelului de date. Niciun instrument, astăzi, nu are acces simultan la toate aceste surse cu capacitatea de a le citi împreună — și nu din limitele următorilor optsprezece luni, ci din felul în care e construită problema.
Întrebările care preced încrederea în instrument #
Niciuna dintre aceste întrebări nu vrea să convingă pe cineva să dezinstaleze observability — toate servesc la a o folosi pentru ce e, cu așteptarea potrivită de la board până la echipa operațională.
1. Instrumentul vede toate nivelurile care compun sistemul, sau doar pe cele pe care a fost instalat collector-ul? Datadog APM acoperă magnific aplicațiile instrumentate; dacă o bucată din fluxul critic trece printr-un serviciu legacy fără agent, instrumentul are un gol. Nu e un defect: e o alegere de perimetru de care se uită adesea după primele șase luni de utilizare.
2. Cine, în echipă, interpretează alertele — și pe baza cărui model mental al sistemului? Un alert care spune «CPU wait anormal pe nodul 2» înseamnă lucruri diferite pentru un sysadmin, un DBA și un dezvoltator. Dacă nu există o convenție internă despre cine interpretează ce, instrumentul generează zgomot, echipa învață să ignore notificările, și valoarea se pierde fără ca nimeni să observe.
3. Când instrumentul a semnalat o anomalie care s-a dovedit a fi un simptom al unei cauze mai profunde, cineva a scris ce se întâmplase? Memoria organizațională a incidentelor e adesea mai săracă decât memoria instrumentului. Un runbook post-mortem care leagă «alerta X era de fapt simptomul lanțului Y» valorează, pe termen mediu, mai mult decât un upgrade al tier-ului instrumentului.
4. Dacă instrumentul ar arăta metrici în verde timp de șase săptămâni consecutive, ce ai verifica oricum? E întrebarea pe care un medic de familie experimentat ar pune-o unui pacient cu toate analizele normale dar obosit de prea mult timp. Un sistem poate avea toate graficele verzi și să pregătească colapsul: o coadă silențioasă de sesiuni în wait pe o structură de lock, un tabel care crește în afara modelului, o procedură care intră în buclă în fiecare primă luni a lunii și se rezolvă înainte de pragul de alertă. Verde e o veste bună, nu o garanție.
Ce cere cu adevărat boardul #
Întrebarea boardului — «de ce instrumentul nu ne-a avertizat?» — ascunde aproape întotdeauna o altă întrebare, mai incomodă de pus explicit: «cine, aici, citește sistemul în întregime, dincolo de bucata lui?». Când răspunsul e «în mod structurat, nimeni», instrumentul devine cel mai simplu lucru de indicat ca insuficient. E de înțeles, și e și o bună ocazie de conversație — pentru că răspunsul real nu e «luăm un instrument mai inteligent», ci «asigurăm-ne că cineva, cu timpul și mandatul necesar, citește instrumentele pe care le avem deja cu tabloul complet în minte».
Acel cineva poate fi intern — un senior cu perimetrul potrivit, protejat de zgomotul operațional, cu autoritatea de a vorbi boardului când e nevoie. Poate fi secondat din exterior în formă continuativă, ca punct de vedere independent. În unele momente — o reconstrucție post-incident, un dubiu asupra unui deviz de platformă — poate fi adus din exterior în formă țintită, cu un mandat precis și circumscris. Niciunul dintre aceste trei drumuri nu cere să înlocuiești instrumentul de observability: toate trei îl fac în sfârșit util pentru ce e, un aliat diagnostic care are nevoie de un cititor competent.
O întrebare de dus cu tine #
Nu există un principiu universal despre observability. Există, pentru fiecare organizație care are una matură, o întrebare care merită pusă la următorul post-mortem:
«Instrumentul a arătat în timp real ce s-a întâmplat — și în cele două săptămâni anterioare cineva citise acele grafice cu un model cauzal în minte, sau fiecare se uita la bucata lui?»
Dacă răspunsul are vreo ezitare, data viitoare când boardul va întreba «dar nu luaserăm Datadog?», conversația va fi mai ușor de purtat — pentru că răspunsul nu va fi despre vendor, ci despre ce am învățat să citim între timp.
Ivan Luminaria este Technical Leader pentru baze de date mission-critical. Lucrează cu CIO, CTO și IT Director din bănci mid-tier, asigurări, telco, utilități și mari instituții publice italiene, cu o metodă de lectură cross-layer construită în aproape treizeci de ani de sisteme reale.
Glosar candidat #
- Observability — capacitatea unui sistem de a fi înțeles din exterior prin metricile, log-urile și trace-urile pe care le emite; nu e sinonimă cu monitoring-ul, ci îl include și îl depășește.
- AIOps — aplicarea tehnicilor de inteligență artificială și machine learning la operațiunile IT, în special pentru corelarea automată a anomaliilor și reducerea zgomotului de alertă.
- Wait event — în contextul bazelor de date Oracle, un eveniment de așteptare înregistrat când o sesiune nu poate avansa din cauza unui blocaj de resurse (lock, I/O, latch); baza diagnosticii de performanță.
- Cross-layer analysis — metodă de analiză a incidentelor care traversează simultan mai multe straturi ale stivei tehnologice (aplicație, bază de date, infrastructură, OS) pentru a reconstitui lanțul cauzal complet.
- Post-mortem — document de analiză retrospectivă a unui incident, cu scopul de a identifica cauza rădăcină și de a preveni recurența; în culturile DevOps mature, e blameless și orientat spre sistem, nu spre individ.