- Ivan Luminaria/
- Database Strategy/
- MySQL/
- 128 MB pe o mașină de 32 GB: cum dimensionezi corect InnoDB buffer pool în MySQL/
128 MB pe o mașină de 32 GB: cum dimensionezi corect InnoDB buffer pool în MySQL
128 MB pe o mașină de 32 GB #
Alerta a venit într-o joi dimineață: latența medie a interogărilor în creștere, vârfuri peste 100ms pe operații care în teorie ar fi trebuit să fie rapide. O aplicație e-commerce, MySQL 8.0, server cu 32 GB RAM. Echipa verificase deja indecșii, reverizuise deja cele mai lente interogări, adăugase câteva EXPLAIN. Totul părea rezonabil pe hârtie.
Apoi cineva s-a uitat la innodb_buffer_pool_size.
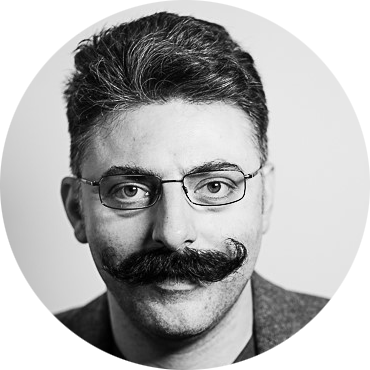
128 MB. Valoarea implicită. Pe o mașină cu 32 GB RAM disponibili, MySQL folosea 128 MB ca memorie cache pentru datele InnoDB. 95% din citiri ajungeau pe disc. Hit ratio-ul buffer pool-ului era sub 50%.
Nu era o problemă de interogări. Era o problemă de configurare de bază pe care nimeni nu o atinsese de la provizionarea inițială.
Ce face buffer pool-ul, cu adevărat #
Buffer pool-ul este structura centrală de memorie a InnoDB. Când MySQL citește o pagină de pe disc — fie că e un rând dintr-un tabel, un nod al unui index B-tree sau date undo — o încarcă în memorie în buffer pool. Citirile ulterioare ale aceleiași pagini sunt servite din RAM, nu de pe disc. La scriere, InnoDB modifică mai întâi pagina în memorie (pagina „dirty") și apoi o sincronizează pe disc în fundal prin mecanismul de flush.
Structura internă folosește o variantă a algoritmului LRU (Least Recently Used): paginile accesate cel mai recent rămân în vârf, cele mai puțin folosite sunt evicted pentru a face loc celor noi. InnoDB implementează o versiune cu două zone — o „young list" pentru paginile accesate recent și o „old list" pentru cele candidate la eviction — pentru a evita ca full scan-urile pe tabele mari să scoată din cache paginile fierbinți [1].
Paginile dirty sunt scrise pe disc de thread-ul de flush din fundal. Parametrul innodb_io_capacity controlează câte operații I/O pe secundă poate folosi InnoDB în acest scop. Dacă buffer pool-ul e prea mic, rata de eviction e ridicată, paginile dirty sunt flushed continuu, iar discul devine gâtuirea chiar și pe hardware rapid.
Cu 128 MB de buffer pool și tabele care ocupă în total câțiva GB, orice interogare care atinge date nerecente ajunge pe disc. Pe un e-commerce cu pattern-uri de acces distribuite pe catalog de produse, comenzi, sesiuni utilizator, rezultatul e exact ceea ce vedea echipa: latență ridicată, I/O saturat, CPU relativ liniștit.
Regula 70-80% — și când nu se aplică #
Recomandarea standard pentru un server dedicat MySQL este să aloce buffer pool-ului între 70% și 80% din RAM disponibil [2]. Pe 32 GB, asta înseamnă între 22 și 26 GB. În cazul de față, am ajuns la 24 GB — aproximativ 75%.
-- Verifică valoarea curentă
SHOW VARIABLES LIKE 'innodb_buffer_pool_size';

-- Modificare la runtime (MySQL 5.7.5+, InnoDB dynamic resize)
SET GLOBAL innodb_buffer_pool_size = 25769803776; -- 24 GB în bytes
Începând cu MySQL 5.7.5, redimensionarea buffer pool-ului se face online fără restart, deși operația nu e instantanee: InnoDB redimensionează pool-ul în chunk-uri, iar în timpul procesului există un impact ușor asupra performanței. Merită făcut prima dată într-o fereastră de activitate redusă, apoi valoarea intră în fișierul de configurare.
# /etc/mysql/mysql.conf.d/mysqld.cnf
[mysqld]
innodb_buffer_pool_size = 24G
Regula 70-80% e valabilă pentru servere dedicate. Dacă mașina găzduiește și aplicația, un web server sau alte procese cu amprentă de memorie semnificativă, trebuie să cobori. Un sistem care intră în swap din cauza buffer pool-ului e mai rău decât un buffer pool mic: swap-ul pe disc e mult mai lent decât orice I/O normal de baze de date.
Instanțe de buffer pool: contența pe mutex-uri #
Cu un buffer pool mare, intră în joc un al doilea parametru: innodb_buffer_pool_instances.
Buffer pool-ul e protejat de mutex-uri interne. Pe sisteme cu mulți thread-uri concurente, un singur pool mare devine o gâtuire din cauza contenței pe aceste lock-uri. Soluția e să împarți pool-ul în instanțe independente, fiecare cu propriul set de mutex-uri și propria listă LRU [3].
Regula practică: o instanță pentru fiecare GB de buffer pool, până la maximum 64. Pentru 24 GB, 8 instanțe e un punct de plecare rezonabil.
[mysqld]
innodb_buffer_pool_size = 24G
innodb_buffer_pool_instances = 8
Un detaliu important: innodb_buffer_pool_instances are efect doar dacă innodb_buffer_pool_size e cel puțin 1 GB. Cu 128 MB implicit, parametrul e ignorat. Acesta e un alt motiv pentru care problema era invizibilă până când nu te uitai la configurarea de bază.
Pe workload-uri cu concurență ridicată — iar un e-commerce cu vârfuri de trafic se încadrează — diferența dintre una și opt instanțe poate fi măsurabilă chiar și după rezolvarea problemei principale de dimensionare.
Citirea semnalelor: hit ratio și pagini dirty #
Înainte de a atinge orice parametru, punctul de plecare e să înțelegi ce se întâmplă. SHOW ENGINE INNODB STATUS e comanda care povestește viața internă a InnoDB la un moment dat [4].
SHOW ENGINE INNODB STATUS\G
Output-ul e verbos. Secțiunea relevantă pentru buffer pool e BUFFER POOL AND MEMORY:
----------------------
BUFFER POOL AND MEMORY
----------------------
Total large memory allocated 137363456
Dictionary memory allocated 409606
Buffer pool size   8192
Free buffers       1024
Database pages     7168
Old database pages 2624
Modified db pages  512
Pending reads      0
Pending writes: LRU 0, flush list 0, single page 0
Pages made young 1847392, not young 284719
0.00 youngs/s, 0.00 non-youngs/s
Pages read 9284719, created 48291, written 284719
0.00 reads/s, 0.00 creates/s, 0.00 writes/s
Buffer pool hit rate 501 / 1000, young-making rate 0 / 1000 not 0 / 1000
Linia cheie e Buffer pool hit rate. În formatul X / 1000, o valoare de 501 înseamnă hit ratio de 50,1% — la fiecare două citiri, una ajunge pe disc. Obiectivul în producție e să rămâi peste 990/1000, ideal 995+.
Pentru monitorizare mai granulară, tabelele performance_schema și information_schema expun metrici per instanță:
SELECT
  pool_id,
  pool_size,
  free_buffers,
  database_pages,
  hit_rate,
  pages_made_young,
  pages_not_made_young
FROM information_schema.INNODB_BUFFER_POOL_STATS;
Modified db pages (paginile dirty) merită atenție: un număr ridicat și stabil indică că flush-ul nu reușește să țină pasul cu scrierile. Dacă crește progresiv, e un semnal că innodb_io_capacity trebuie revizuit în raport cu hardware-ul disponibil.
Restartul și problema cold start #
Există un aspect al buffer pool-ului care e adesea ignorat până la primul restart în producție: după un repornire, pool-ul e gol. Toate paginile fierbinți care erau în memorie sunt pierdute. Sistemul repornește rece, iar pentru o perioadă variabilă — de la minute la ore, în funcție de workload și dimensiunea pool-ului — performanța e degradată în timp ce InnoDB reîncarcă progresiv datele de pe disc.
MySQL oferă un mecanism pentru a atenua asta: dump-ul și restore-ul buffer pool-ului [5].
[mysqld]
# Salvează buffer pool-ul la shutdown
innodb_buffer_pool_dump_at_shutdown = ON

# Procentul de pagini de salvat (implicit 25)
innodb_buffer_pool_dump_pct = 25

# Încarcă buffer pool-ul la startup
innodb_buffer_pool_load_at_startup = ON
Cu innodb_buffer_pool_dump_at_shutdown = ON, MySQL salvează într-un fișier (implicit ib_buffer_pool în datadir) identificatorii paginilor care se aflau în pool la momentul shutdown-ului. La următorul startup, cu innodb_buffer_pool_load_at_startup = ON, paginile sunt reîncărcate în fundal.
Fișierul conține doar identificatorii (tablespace ID și page number), nu datele: restore-ul necesită ca MySQL să recitească paginile de pe disc, dar o face în mod organizat și prioritizat, reducând semnificativ timpul de warm-up.
E posibil și să forțezi dump-ul și restore-ul la runtime, fără a aștepta un shutdown:
-- Dump manual al buffer pool-ului
SET GLOBAL innodb_buffer_pool_dump_now = ON;

-- Restore manual (util după un restart neplanificat)
SET GLOBAL innodb_buffer_pool_load_now = ON;

-- Monitorizează progresul restore-ului
SHOW STATUS LIKE 'Innodb_buffer_pool_load_status';
În cazul de față, după configurarea dump-ului automat și efectuarea unui restart controlat pentru a aplica noii parametri, warm-up-ul a durat aproximativ 8 minute în loc de 40-50 cât era de așteptat cu un pool de 24 GB complet rece. Nu e magie: e că 25% din paginile cele mai fierbinți acoperă marea majoritate a acceselor reale.
Cifrele, înainte și după #
Comparația e clară:
| Metrică | Înainte | După |
|---|---|---|
innodb_buffer_pool_size | 128 MB | 24 GB |
innodb_buffer_pool_instances | 1 | 8 |
| Hit ratio | ~50% | ~997/1000 |
| Citiri de pe disc | ~95% | <1% |
| Latență medie interogări | 45ms | 3ms |
| Throughput (interogări/s) | baseline | ~2× |
Latența de la 45ms la 3ms nu e rezultatul unei interogări rescrise sau al unui index adăugat. E rezultatul de a nu mai citi de pe disc ceea ce putea sta în RAM. Discul era gâtuirea, iar gâtuirea era acolo din ziua provizionării.
Throughput-ul dublat e o consecință directă: mai puțină așteptare pe I/O înseamnă mai multe interogări servite în același timp, cu același CPU.
Ce rămâne de ținut minte #
Buffer pool-ul nu e singurul parametru care contează în MySQL, dar e probabil cel cu cel mai mare raport impact/complexitate. Un server cu 32 GB RAM și 128 MB de buffer pool e ca un depozit cu 32 de camere care folosește doar una pentru a stoca marfa: restul muncii se face oricum, dar cu costuri enorm mai mari.
Ideea nu e că valoarea implicită e greșită în absolut — 128 MB are sens pe o mașină partajată cu puțin RAM sau într-un mediu de dezvoltare. Ideea e că valoarea implicită nu e niciodată revizuită la momentul provizionării în producție, și nimeni nu-și dă seama până când sistemul nu începe să sufere.
Diagnosticul pornește întotdeauna de la hit ratio. Dacă e sub 990/1000, buffer pool-ul e primul loc unde te uiți. Apoi vin instanțele, apoi warm-up-ul, apoi tot restul.
Echipa a configurat și o alertă pe hit ratio: sub 985/1000 pentru mai mult de cinci minute, se declanșează o notificare. Nu pentru că s-ar aștepta să revină la problema de dinainte, ci pentru că sistemele se schimbă — datele cresc, pattern-urile de acces se modifică, apare un modul nou — și e mai bine să știi înainte ca latența să revină la 45ms.
Surse oficiale #
- MySQL 8.0 Reference Manual — Making the Buffer Pool Scan Resistant
- MySQL 8.0 Reference Manual — Configuring InnoDB Buffer Pool Size
- MySQL 8.0 Reference Manual — Configuring Multiple Buffer Pool Instances
- MySQL 8.0 Reference Manual — SHOW ENGINE INNODB STATUS
- MySQL 8.0 Reference Manual — Saving and Restoring the Buffer Pool State
Glosar #
InnoDB buffer pool — Zona principală de memorie a InnoDB unde sunt cachate paginile de date și indecși. Cu cât e mai mare, cu atât mai puține citiri ajung pe disc. Parametru:
innodb_buffer_pool_size.Hit ratio (buffer pool) — Procentul de citiri servite din memorie față de total. Se exprimă în formatul X/1000 în output-ul
SHOW ENGINE INNODB STATUS. Valori sub 990/1000 indică dependență excesivă de disc.Pagină dirty — Pagină din buffer pool modificată în memorie dar neîncă sincronizată pe disc. InnoDB le gestionează prin flush în fundal; un număr ridicat și în creștere semnalează că flush-ul nu reușește să țină pasul cu scrierile.
LRU list (InnoDB) — Structură cu două zone (young list + old list) folosită de InnoDB pentru a decide ce pagini să păstreze în cache și ce pagini să elimine. Protejează paginile fierbinți de eviction cauzată de full scan-uri ocazionale.
Buffer pool warm-up — Procesul de reîncărcare a paginilor fierbinți în buffer pool după un restart. Cu
innodb_buffer_pool_dump_at_shutdownșiinnodb_buffer_pool_load_at_startup, MySQL salvează și restaurează identificatorii paginilor, reducând timpul de cold start de la ore la minute.