- Ivan Luminaria/
- Database Strategy/
- MySQL/
- Telefonul de la 8 și 40: recovery Galera Cluster cu doi noduri căzute/
Telefonul de la 8 și 40: recovery Galera Cluster cu doi noduri căzute
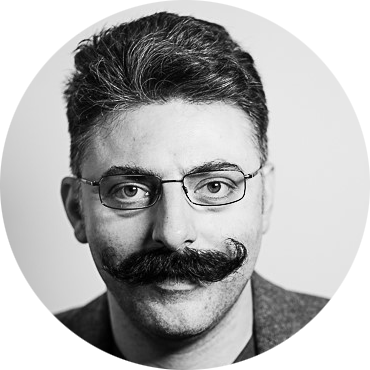
Telefonul de la 8 și 40 #
Era dimineață devreme. Terminam primul cafea când a sunat telefonul: un coleg aflat la un client, cu vocea puțin tensionată. Îmi povestește că sistemul de monitorizare tocmai a declanșat două alerte în succesiune pe un cluster Galera cu trei noduri. Îmi citește primul ticket:
Cluster Galera, unul dintre noduri este căzut. Valoare detectată: 2. Nodul care a generat alerta:
mysql-node-01.
wsrep_cluster_size = 2. Un nod căzut. Îi spun că nu e o urgență imediată — clusterul funcționează în continuare cu două noduri din trei, quorum-ul ține. „Deschide o consolă pe nodul care a alertat și vedem ce s-a întâmplat", îi sugerez. Dar în timp ce se conecta prin SSH, sosește al doilea ticket:
Cluster Galera, unul dintre noduri este căzut. Valoare detectată: 2. Nodul care a generat alerta:
mysql-node-02.
Două tickete, aproape în succesiune. Al doilea venea de la un nod diferit, dar raporta tot 2 ca valoare — ceea ce însemna că din perspectiva lui mysql-node-02, clusterul mai avea doi membri. „Ok, acum situația se schimbă", îi spun. „Care dintre cei doi rămăsese? Nodul care a declanșat prima alertă era deja căzut când a sosit a doua, sau nu?"
Acest articol este continuarea firească a celui despre configurarea unui Galera Cluster cu 3 noduri [articolul #33]. Acela explică cum se construiește. Acesta povestește ce se întâmplă în ziua în care nodurile încep să cadă unul după altul — și cum revii operațional, probabil în timp ce ghidezi un coleg la telefon cu clientul în spate.
Cum numără clusterul membrii săi (și de ce acel număr e totul) #
Înainte să-i trimit comenzile de executat, i-am cerut treizeci de secunde să-i reamintesc mecanismul care genera alertele — pentru că în panică e ușor să privești numerele fără să le citești cu adevărat.
Galera menține intern conceptul de Primary Component (PC): subsetul de noduri care deține quorum-ul și poate continua să proceseze scrieri. Când un nod iese, celelalte se pun de acord asupra cine face parte din PC prin protocolul de membership. Variabila care expune această stare este wsrep_cluster_size [1]:
SHOW GLOBAL STATUS LIKE 'wsrep_cluster_size';
SHOW GLOBAL STATUS LIKE 'wsrep_cluster_status';
SHOW GLOBAL STATUS LIKE 'wsrep_local_state_comment';
Într-un cluster sănătos cu 3 noduri, wsrep_cluster_size are valoarea 3 pe toate nodurile, iar wsrep_cluster_status raportează Primary. Când un nod iese, cele două rămase văd wsrep_cluster_size = 2 — dar continuă să funcționeze pentru că mai au quorum (2 din 3 > 50%).
Situația devine critică când ies două noduri din trei. Nodul rămas nu are quorum: nu poate ști dacă el este cel izolat sau dacă celelalte două au probleme. Pentru a evita split-brain — două partiții care acceptă ambele scrieri divergente — Galera aplică o regulă simplă: fără quorum, nicio scriere. Nodul supraviețuitor trece în starea non-Primary și încetează să accepte DML.
Monitorizarea clientului era configurată să alerteze la wsrep_cluster_size < 3. Corect. Dar cele două alerte aproape simultane sugerau un scenariu mai complex decât un simplu nod repornit — și voiam ca și colegul să ajungă la aceeași concluzie înainte de a tasta vreo comandă invazivă.
Diagnostic: ce se întâmplase de fapt #
„Primul lucru pe care îl facem este să construim o hartă temporală", îi spun. „Cine a căzut primul? În ce stare sunt nodurile acum? Du-te pe al treilea nod, cel care nu a declanșat nicio alertă."
Pe al treilea nod (mysql-node-03, cel silențios) îl pun să ruleze:
SHOW GLOBAL STATUS LIKE 'wsrep%';
Îmi citește output-ul relevant:
wsrep_cluster_size          | 1
wsrep_cluster_status        | non-Primary
wsrep_local_state_comment   | Initialized
wsrep_connected             | ON
wsrep_ready                 | OFF
„Ok, situație neplăcută", comentez. wsrep_cluster_size = 1 și wsrep_cluster_status = non-Primary. Nodul era încă în picioare, conectat la rețea, dar nu accepta scrieri. Pierduse quorum-ul.
Îl rog să încerce să se conecteze la celelalte două. Pe mysql-node-01 și mysql-node-02 MySQL nu răspunde — ambele căzute. Îl pun să deschidă error log-ul lui mysql-node-01 și îmi citește:
[ERROR] WSREP: gcs/src/gcs_group.cpp:gcs_group_handle_join_msg():736:
  Member 1 (mysql-node-02) requested state transfer from '*any*'.
[Warning] WSREP: Member 1 (mysql-node-02) is waiting for SST from donor.
[ERROR] WSREP: Process completed with error: wsrep_sst_xtrabackup-v2 ...
[ERROR] WSREP: SST failed: 32 (Broken pipe)
„Iată secvența", îi explic. mysql-node-01 ieșise primul (probabil din cauza unei probleme de rețea sau OOM), mysql-node-02 încercase să reintre în cluster prin SST (State Snapshot Transfer), SST-ul eșuase, și între timp și mysql-node-02 căzuse. Nodul rămas, mysql-node-03, se trezise singur și pierduse quorum-ul.
Cauzele cele mai frecvente pe care merită să le excluzi #
„Înainte să trecem la recovery, să înțelegem de ce iese un nod", îi spun. Nu e necesar pentru fix-ul imediat, dar ca să nu ne regăsim în aceeași situație peste două ore. Cauzele cele mai frecvente în producție:
- Probleme de rețea: latență mare sau packet loss între noduri. Galera folosește
evs.suspect_timeoutșievs.inactive_timeoutpentru a decide când să expulzeze un nod. Un nod lent la răspuns este expulzat chiar dacă MySQL e sănătos. - OOM killer: kernel-ul Linux termină
mysqlddin cauza presiunii de memorie. Se vede îndmesgsau/var/log/messages. - Slow applier: nodul nu reușește să țină pasul cu fluxul de writeset-uri.
wsrep_local_recv_queue_avgridicat este un semnal. - gcache overflow: dacă nodul a fost offline suficient de mult timp încât writeset-urile necesare să nu mai fie în gcache-ul celorlalte noduri, nu poate face IST și trebuie să facă SST — mult mai costisitor.
Îl pun să se uite la dmesg pe mysql-node-01. Îi ia zece secunde: Out of memory: Kill process [mysqld] cu aproximativ 20 de minute înainte de prima alertă. OOM killer, candidatul principal. Îl notez mental pentru mai târziu — mai întâi recuperăm clusterul.
SST și IST: nu e același lucru să reintri în cluster #
„Acum îți explic de ce a eșuat SST-ul, ca să înțelegi ce trebuie să evităm când vom readuce nodurile", îi spun.
Când un nod reintrare după o absență, Galera trebuie să-l sincronizeze cu starea curentă a clusterului. Există două moduri [2]:
IST (Incremental State Transfer): nodul primește doar writeset-urile pe care le-a ratat, din gcache-ul celorlalte noduri. Este rapid, nu întrerupe donor-ul, nu necesită un backup complet. Funcționează doar dacă gap-ul este mic și writeset-urile necesare sunt încă în gcache.
SST (State Snapshot Transfer): transfer complet al stării — practic un backup fizic (cu xtrabackup, mysqldump sau rsync) de la donor la joiner. Este lent, poate pune presiune pe donor, și în timpul SST-ului donor-ul poate deveni non-responsive pentru citiri (depinde de metodă). Este necesar când gap-ul este prea mare pentru IST.
Distincția practică: dacă un nod a fost offline câteva minute și gcache-ul este dimensionat corect (wsrep_provider_options = "gcache.size=2G" ca punct de plecare), IST este aproape garantat. Dacă nodul a fost offline ore sau zile, SST este inevitabil.
„În cazul vostru", îi spun, „SST-ul eșuat este punctul critic". mysql-node-02 încercase să reintre, donor-ul începuse transferul, dar ceva întrerupsese procesul (Broken pipe din log sugera o problemă de conexiune în timpul transferului). Și între timp mysql-node-02 rămăsese într-o stare inconsistentă — nici înăuntru, nici afară.
Procedura de recovery: ordine și răbdare #
„Ok, acum recompunem. Cu două noduri căzute și unul în non-Primary, ordinea contează mai mult decât orice altceva. Nu porni nimic înainte să-ți spun eu."
Pasul 1: identifică nodul cel mai actualizat #
Înainte de a readuce orice nod, trebuie să înțelegem care are secvența de tranzacții cea mai avansată. Acesta va deveni donor-ul pentru celelalte.
„Du-te pe fiecare nod, inclusiv pe cele cu MySQL căzut, și citește-mi fișierul de stare Galera":
cat /var/lib/mysql/grastate.dat
Output tipic:
# GALERA saved state
version: 2.1
uuid:    6b3f8c2a-1234-11ee-abcd-0242ac110003
seqno:   847392
safe_to_bootstrap: 0
Nodul cu seqno cel mai mare este cel mai actualizat. Dacă safe_to_bootstrap: 1, Galera însuși a identificat deja acel nod ca sigur pentru bootstrap. Dacă toate nodurile arată safe_to_bootstrap: 0 (scenariu frecvent după un crash simultan), trebuie ales manual nodul cu seqno cel mai mare și modificat fișierul.
Pasul 2: bootstrap-ul nodului cel mai actualizat #
„Acum urmează partea delicată, deci urmărește-mă pas cu pas și nu te grăbi." Bootstrap-ul de urgență este momentul cel mai delicat: e vorba de a porni primul nod ca nou Primary Component, fără a aștepta celelalte.
# Pe nodul cu seqno cel mai mare, modifică grastate.dat
# Setează safe_to_bootstrap: 1

# Apoi pornește cu --wsrep-new-cluster
galera_new_cluster
# sau, în funcție de distribuție:
mysqld_safe --wsrep-new-cluster &
Aceasta creează un cluster nou cu un singur membru. Nodul devine Primary și începe să accepte scrieri. Atenție: dacă se face bootstrap pe nodul greșit (cel cu seqno mai mic), se pierd tranzacțiile deja committate pe nodul mai avansat. „Ia-ți două minute în plus și verifică seqno-urile tuturor celor trei noduri înainte de a alege. Mai bine două minute acum decât un rollback complicat după."
Îmi citește valorile: mysql-node-03 (singurul rămas în picioare) avea seqno: 847392, în timp ce mysql-node-01 arăta seqno: 847389. „Bine, bootstrap-ul se face pe mysql-node-03."
Pasul 3: readucerea nodurilor unul câte unul #
„Așteaptă ca primul nod să fie Primary, apoi trecem la al doilea. Unul câte unul, te rog." Se pornesc normal (fără --wsrep-new-cluster) și Galera gestionează sincronizarea:
systemctl start mysql
Nodul care reintrare se conectează la cluster, negociază IST sau SST și se sincronizează. În această fază, îl pun să țină deschis un ciclu de control pe:
SHOW GLOBAL STATUS LIKE 'wsrep_local_state_comment';
-- Progresie așteptată: Joining -> Waiting for SST -> Joined -> Synced
„Așteaptă Synced înainte să atingi al treilea nod. Dacă le pornești pe toate odată, crești sarcina pe donor și riscăm un alt SST eșuat — și atunci o luăm de la capăt."
Pas cu pas, cu colegul la telefon #
În acel moment convorbirea a devenit operațională. Îi dictam comenzile, el le executa și îmi citea output-ul. A mers așa:
- Verificat
grastate.datpe toate cele trei noduri.mysql-node-03avea seqno-ul cel mai mare și era deja în picioare (în stareanon-Primary). - Repornit
mysql-node-03cugalera_new_clusterdupă ce am setatsafe_to_bootstrap: 1îngrastate.dat-ul său. Nodul a trecut imediat laPrimarycuwsrep_cluster_size = 1. „Bine, respirăm un moment." - Pornit
mysql-node-01. A negociat IST (gap-ul era de câteva mii de writeset-uri, gcache-ul era suficient). Sincronizat în aproximativ 3 minute. Colegul îmi citeșteSyncedși simt că se mai relaxează puțin. - Pornit
mysql-node-02. Tot IST, sincronizat în 4 minute. - Verificat pe toate cele trei noduri:
wsrep_cluster_size = 3,wsrep_cluster_status = Primary,wsrep_local_state_comment = Synced.
Clusterul revenise operațional. Downtime-ul efectiv pentru scrieri fusese de aproximativ 35 de minute — timpul dintre căderea celui de-al doilea nod și finalizarea bootstrap-ului. Colegul închide apelul cu un „mulțumesc, acum mă duc să explic clientului ce s-a întâmplat". Meritul cel mai mare, îi spun înainte să închid, e că și-a păstrat capul limpede și nu a atins nimic înainte de a înțelege.
Ce mai rămâne de făcut după recovery #
Recovery-ul este partea vizibilă. Partea care contează cel mai mult este ce faci după, când presiunea a scăzut. După-amiaza am mai dat un tur de apel cu colegul ca să punem pe hârtie ce merita remediat.
Despre monitorizare: alerta pe wsrep_cluster_size < 3 era corectă, dar lipsea o alertă pe wsrep_cluster_status != Primary. Sunt două condiții diferite: un cluster poate avea cluster_size = 2 și să fie în continuare Primary (un nod a ieșit dar quorum-ul ține), sau poate avea cluster_size = 1 și să fie non-Primary (nicio scriere posibilă). Al doilea scenariu necesită intervenție imediată, primul are mai multă marjă.
Despre gcache: dimensionarea gcache-ului astfel încât IST să fie posibil pentru absențe scurte. Un gcache de 512MB într-un cluster cu throughput ridicat de scrieri se epuizează în câteva minute. Mărirea lui la 2-4GB reduce drastic necesitatea SST pentru reporniri rapide.
Despre OOM: situația originală era OOM killer pe mysql-node-01. Soluția nu era în clusterul Galera — era în configurația memoriei MySQL (innodb_buffer_pool_size prea agresiv pentru RAM-ul disponibil) și în absența swap-ului. Două lucruri care nu au nimic de-a face cu replicarea, dar care într-un cluster HA devin critice pentru că un crash de proces se propagă ca eveniment de membership.
Despre bootstrap: documentarea procedurii de bootstrap de urgență în runbook-ul operațional, cu comenzile exacte și ordinea corectă. Este o procedură care se face rar, sub presiune, cu clientul care cere actualizări la fiecare cinci minute. Nu e momentul să ți-o amintești din memorie — sau să suni un coleg pentru că nu ți-o mai amintești.
Runbook-ul pe care l-am fi vrut în acea dimineață #
Aceasta este versiunea sintetică a procedurii, de ținut la îndemână — cea pe care colegul și-a salvat-o într-un fișier în repo-ul clientului înainte de a încheia ziua:
# 1. Verifică starea pe toate nodurile
mysql -e "SHOW GLOBAL STATUS LIKE 'wsrep%';" 2>/dev/null || echo "MySQL down"

# 2. Citește seqno din grastate.dat (chiar dacă MySQL e căzut)
cat /var/lib/mysql/grastate.dat

# 3. Pe nodul cu seqno cel mai mare: activează bootstrap
sed -i 's/safe_to_bootstrap: 0/safe_to_bootstrap: 1/' /var/lib/mysql/grastate.dat

# 4. Bootstrap-ul primului nod
galera_new_cluster

# 5. Verifică că e Primary
mysql -e "SHOW GLOBAL STATUS LIKE 'wsrep_cluster_status';"

# 6. Pornește celelalte noduri unul câte unul
systemctl start mysql
# Așteaptă Synced înainte de următorul

# 7. Verificare finală pe toate nodurile
mysql -e "SHOW GLOBAL STATUS LIKE 'wsrep_cluster_size'; SHOW GLOBAL STATUS LIKE 'wsrep_cluster_status';"
Simplu pe hârtie. Mai puțin simplu când ești la un client, ai al doilea ticket pe monitor și aștepți ca cineva de la celălalt capăt al telefonului să-ți spună de unde să începi.
Fonti ufficiali #
- Codership — Galera Cluster Documentation: wsrep Status Variables <TODO: scout URL specifico per wsrep_cluster_size>
- Percona Documentation — State Snapshot Transfer (SST) and Incremental State Transfer (IST)
- Codership — Galera Cluster Recovery <TODO: scout URL specifico per bootstrap di emergenza>
- Percona Blog — gcache sizing <TODO: scout URL aggiornato>
Glosar #
Primary Component (PC) (Galera) — Subsetul de noduri care deține quorum-ul și poate continua să proceseze scrieri. Un nod în afara PC trece în starea
non-Primaryși încetează să accepte DML pentru a evita split-brain.wsrep_cluster_size (Galera) — Variabilă de stare care raportează numărul de noduri prezente în clusterul Galera. Valoare așteptată într-un cluster cu 3 noduri:
3. Scăderea sub pragul de quorum (≤ 1 din 3) blochează scrierile.IST (Incremental State Transfer) (Galera) — Sincronizare incrementală a unui nod care reintrare în cluster: primește doar writeset-urile lipsă din gcache-ul celorlalte noduri. Rapid și non-invaziv pentru donor; posibil doar dacă gap-ul este acoperit de gcache.
SST (State Snapshot Transfer) (Galera) — Transfer complet al stării de la un nod donor la un joiner: echivalent cu un backup fizic complet. Necesar când gap-ul este prea mare pentru IST. Poate încetini donor-ul în timpul transferului.
gcache (Galera) — Buffer circular pe disc pe care fiecare nod Galera îl menține pentru a păstra writeset-urile recente. Dimensionarea corectă a gcache-ului (
gcache.size) este principala pârghie pentru a favoriza IST față de SST la reporniri scurte.