- Ivan Luminaria/
- Database Strategy/
- Leadership tecnica e progetti/
- Latenza WAN e change control GxP: il costo reale del lift-and-shift/
Latenza WAN e change control GxP: il costo reale del lift-and-shift
Lift-and-shift adesso, ottimizziamo dopo: quanto costa il «dopo» in un sistema validato #
Perché in una migrazione cloud la fase più economica per ripensare il database è quella prima del trasloco — e cosa succede quando, dopo il go-live, ogni modifica deve passare dal change control GxP.
Il business case era corretto #
Il documento che il comitato investimenti aveva approvato era fatto bene. Un’azienda farmaceutica di medie dimensioni, tre stabilimenti produttivi, un data center di proprietà con il contratto di hosting in scadenza e un parco server arrivato a fine supporto. Al centro, un database Oracle da circa 6 TB su cui girano il sistema di gestione della qualità, il LIMS dei laboratori di controllo e la reportistica di rilascio lotti. Il piano era chiaro: spostare tutto su infrastruttura cloud in nove mesi, lift-and-shift, stessa versione, stessa architettura applicativa, nessuna riscrittura. Ottimizzazione e modernizzazione in una seconda fase, già prevista a budget per l’anno successivo.
La scelta aveva una logica solida, e chi l’ha presa non ha sbagliato i conti che aveva davanti. Il contratto del data center imponeva la data. La riscrittura applicativa avrebbe richiesto una nuova validazione completa dei sistemi, con tempi incompatibili con la scadenza. «Prima usciamo dal data center, poi ottimizziamo con calma» era, a quel tavolo, la frase più ragionevole possibile.
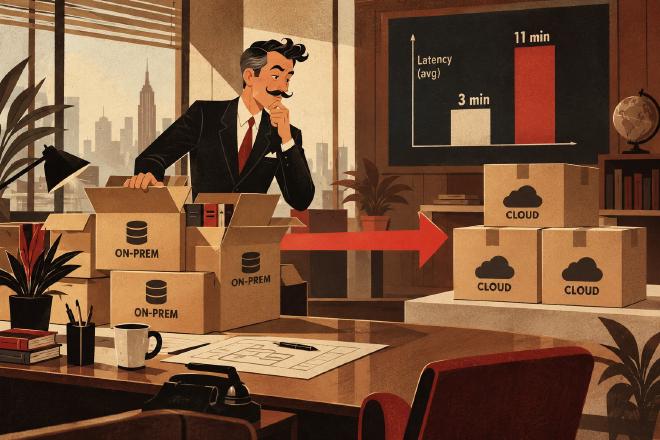
Il go-live è arrivato nei tempi. Il sistema funzionava. Dopo sei settimane, il direttore Qualità ha chiesto perché il report di rilascio lotti, che prima girava in tre minuti, adesso ne impiegava undici.
Undici minuti, e da dove arrivano #
La risposta non stava nel database. I server applicativi del LIMS erano rimasti in uno degli stabilimenti — collegati a strumenti di laboratorio che non si potevano spostare — mentre il database era andato in cloud. Una scelta sensata sulla carta: l’applicazione restava vicina agli strumenti, il database andava dove costava meno gestirlo.
Il report di rilascio, scritto quindici anni prima per una LAN, non eseguiva una query: ne eseguiva centinaia di migliaia, una per ogni riga di risultato analitico, in un ciclo applicativo. Nell’AWR la firma è inconfondibile: la statistica SQL*Net roundtrips to/from client altissima rispetto alle user calls utili, e il tempo dominato dall’evento SQL*Net message from client — il database fermo ad aspettare il client.
I conti, una volta messi in fila, sono semplici:
- circa 180.000 round-trip per esecuzione del report;
- in LAN, latenza di circa 0,3 ms per round-trip → 54 secondi di rete su tre minuti totali;
- tra stabilimento e region cloud, circa 3 ms → 540 secondi di sola rete, nove minuti;
- il resto del lavoro (circa due minuti) identico prima e dopo.
Tre minuti diventano undici senza che una singola query sia peggiorata. Il database, in cloud, era perfino più veloce. (Numeri rappresentativi di contesti analoghi — DA VERIFICARE prima della pubblicazione: latenza effettiva stabilimento-region e conteggio round-trip vanno calibrati su un caso documentabile.)
Nel frattempo la fattura mensile era arrivata al 35% sopra il business case. Le istanze erano state dimensionate sul picco storico on-premises, con margine, perché nessuno voleva rischiare la performance in un sistema validato; lo storage era stato scelto sul tier che garantiva gli IOPS del vecchio array; i backup erano stati replicati con la stessa politica di retention di prima, ora pagata al gigabyte. (Percentuale DA VERIFICARE.)
Perché il «dopo» costa più del «prima» #
Fin qui è una storia che chiunque abbia fatto una migrazione cloud riconosce: un’applicazione chatty, una latenza che prima era invisibile, un dimensionamento prudente. La parte specifica del settore farmaceutico arriva quando si apre la fase due.
Il database e il LIMS sono sistemi computerizzati validati: supportano decisioni GxP, e ricadono sotto l’EU GMP Annex 11 e, per i prodotti destinati al mercato americano, sotto il 21 CFR Part 11. Ogni modifica a un sistema validato passa da change control, valutazione del rischio, test documentati, approvazione della Qualità. Riscrivere il ciclo del report in una query set-based, spostare il calcolo lato database, rivedere il dimensionamento delle istanze: ciascuna di queste modifiche, a sistema in produzione, apre un ciclo di rivalidazione.
Prima della migrazione, quelle stesse modifiche avrebbero viaggiato dentro la validazione della migrazione stessa — che andava fatta comunque. Il pacchetto di test, il protocollo, le firme: tutto era già previsto e pagato. Dopo il go-live, ogni intervento diventa un progetto a sé, con il suo protocollo, le sue firme, la sua finestra di fermo concordata con la produzione.
È questo il punto che il business case non poteva vedere. La fase due era a budget come lavoro tecnico. Nella realtà è un lavoro di validazione, e il suo costo è proporzionale al numero di interventi, non alla loro difficoltà tecnica. Nel caso specifico, la stima della fase due è passata da quattro a undici mesi di calendario quando la Qualità ha messo in fila i change necessari. (DA VERIFICARE.)
Nessuno, in questa storia, ha lavorato male. Il team infrastrutturale ha migrato esattamente quello che gli era stato chiesto, nei tempi. Il team applicativo ha mantenuto il codice invariato per non invalidare la validazione. La Qualità ha fatto il suo mestiere. Il punto debole era nella frase stessa: «ottimizziamo dopo» presuppone che il dopo abbia lo stesso costo del prima.
Il trasloco e gli scatoloni chiusi #
Chi ha traslocato almeno una volta conosce il fenomeno. Il trasloco ha una data, e la data comanda. Le ultime due settimane gli scatoloni si riempiono senza scegliere: «porto tutto, poi sistemo con calma nella casa nuova». Nella casa nuova, gli scatoloni non aperti vanno in cantina. Sono ancora lì cinque anni dopo, e adesso la cantina si paga a metro quadro.
Il momento in cui scegliere costa meno è prima di chiudere lo scatolone — quando lo si ha già in mano. Dopo, aprirlo richiede di scendere in cantina, spostare gli altri, trovare il tempo. Nel cloud la cantina si paga ogni mese; in un sistema validato, per aprire uno scatolone serve anche la firma di qualcun altro.
Quattro domande prima di scrivere «fase due» nel piano #
Nessuna di queste domande serve a rinunciare al lift-and-shift, che resta spesso la scelta giusta quando c’è una scadenza vera. Servono a decidere cosa portare così com’è e cosa vale la pena ripensare finché il costo di ripensarlo è ancora quello della migrazione.
1. Quali componenti restano fuori dal cloud, e quanto parlano con il database? Un’applicazione che resta in stabilimento e un database che va in region trasformano ogni round-trip in latenza WAN. Contare i round-trip per le transazioni critiche — dall’AWR, prima della migrazione — costa un pomeriggio. Moltiplicarli per la latenza misurata tra i due siti dà il tempo che il sistema perderà, prima che lo perda.
2. Il dimensionamento è stato calcolato sul carico misurato o sulla paura del carico? Sul vecchio hardware si comprava una volta per cinque anni, e il margine era gratuito dopo l’acquisto. In cloud il margine si paga ogni ora. Dimensionare sul carico misurato, con un piano esplicito per crescere, è una decisione diversa dal dimensionare «come prima, con un po’ di sicurezza».
3. Quali interventi della fase due toccano un sistema validato, e quanto costa validarli dopo invece che durante? È la domanda che sposta la discussione dal piano tecnico a quello economico. Se la risposta è «li valideremmo comunque durante la migrazione», la fase due costa una frazione di quello che costerà a sistema in produzione.
4. Chi firma la fase due, e con quale budget già approvato? Una fase due senza proprietario e senza budget deliberato è, nei fatti, una cantina. Nominare chi ne risponde e con quali risorse — prima del go-live — è l’unico modo per evitare che diventi un’intenzione.
Cosa questo articolo lascia fuori #
Due temi meritano un articolo a sé e qui restano volutamente fuori: il licensing Oracle in cloud (le regole di conteggio dei vCPU sugli hyperscaler cambiano parecchio i conti del business case) e la residenza dei dati per i dati di qualità e di farmacovigilanza. Chi li ha affrontati in una migrazione GxP ha probabilmente un pezzo di questa storia che qui manca.
Una domanda da portarsi via #
La prossima volta che un piano di migrazione contiene la frase «ottimizzazione in una fase successiva», vale la pena chiedersi:
«Quanti round-trip fa la nostra transazione più critica — e quanto costerà cambiarla dopo, rispetto a cambiarla adesso?»
Per chi ha già attraversato una migrazione con applicazioni rimaste on-premises e database in cloud: quale è stato il primo segnale che il «dopo» sarebbe costato più del previsto?
Glossario #
lift-and-shift — Strategia di migrazione che sposta un sistema da un ambiente a un altro senza modificarne l’architettura, il codice o la configurazione.
AWR — Automatic Workload Repository — strumento diagnostico integrato in Oracle Database per la raccolta e l’analisi delle statistiche di performance.