- Ivan Luminaria/
- Database Strategy/
- Leadership tecnica e progetti/
- Il restart ha risolto. Il problema è ancora lì./
Il restart ha risolto. Il problema è ancora lì.
Il restart ha risolto. Il problema è ancora lì. #
Perché un incident che si chiude senza una catena causale ricostruita non è un episodio isolato — e cosa resta davvero nel sistema per guardare a freddo.
Venerdì, 19:40 #
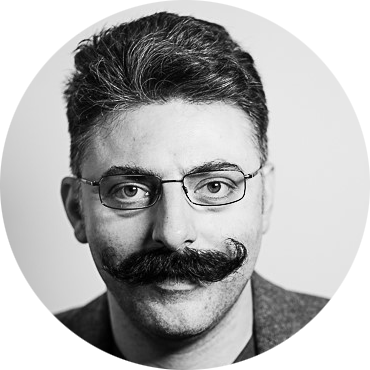
C’è un momento che un CIO conosce bene, e che non si vede nei report. L’incident è iniziato giovedì notte alle 02:17 — un rallentamento su un servizio critico, latenze fuori soglia, qualche sessione in timeout, pochi clienti impattati. Il team di reperibilità si è connesso, ha osservato per quaranta minuti, ha preso qualche traccia, non ha capito. Alle 03:11 la curva è rientrata. Da sola. Il team ha aspettato altri trenta minuti per sicurezza, ha visto il sistema stabilizzarsi, ha chiuso il ponte. Al mattino, il daily stand-up ne ha parlato tre minuti: «è rientrato, teniamolo d’occhio». Nel pomeriggio di venerdì, con tre meeting di business in agenda, nessuno ne ha più parlato.
Alle 19:40 il CIO esce dall’ufficio. Il sistema regge. Il weekend inizia. L’incident entra, senza che nessuno abbia deciso di metterlo lì, nella categoria mentale «episodio occasionale». Non è una decisione formale — è una decisione per sottrazione: nessuno scrive, nessuno chiede, il thread Slack dedicato smette di popolarsi, il post-mortem non viene convocato. Lunedì mattina il sistema regge ancora. Martedì anche. Alla fine della settimana successiva, nel debrief operativo, il tema non compare più nemmeno come riga.
Il momento in cui si perde la finestra di ricostruzione non è il momento dell’incident. È il venerdì sera. Non quando si è rotto, ma quando si è smesso di guardare.
Quello che il sistema ha ancora, anche se nessuno è andato a vedere #
C’è una convinzione diffusa, quasi un’ovvietà del mestiere, che recita: «a incidente rientrato, senza i log del momento, la causa non si ricostruisce più». È vera in un caso solo — quando nessuna traccia è stata conservata. In quasi tutti gli altri casi, il sistema ha più memoria di quanto chi lo opera creda, e la finestra di indagine è molto più lunga di quanto le dinamiche dell’urgenza suggeriscano.
Su un database Oracle, l’AWR (Automatic Workload Repository) conserva snapshot ogni ora, con retention di default di otto giorni e configurabile fino a cinque settimane. Dentro ciascuno snapshot ci sono i wait event dominanti, i piani di esecuzione delle query top, le statistiche di I/O, le sessioni attive, i segmenti più contesi. L’ASH (Active Session History) conserva un campione delle sessioni attive al secondo, in forma circolare, utilizzabile a posteriori per ricostruire cosa stava facendo esattamente ogni sessione nel minuto dell’incident. L’alert log registra errori, lock, scambi di stato. Il sistema operativo conserva metriche di CPU, memoria, I/O. Lo storage conserva pattern di latenza e queue depth. Il repository dei change — se c’è, e andrebbe sempre esserci — registra ogni modifica di configurazione, ogni release applicativa, ogni patch infrastrutturale. L’observability moderna, discussa in un altro articolo di questa serie, conserva serie temporali di settimane o mesi.
Mettere insieme queste fonti dopo settantadue ore richiede metodo — ma è una ricostruzione più accurata, non meno accurata, di quella fatta a caldo nel pieno dell’emergenza. A caldo si cerca per fermare il sintomo. A freddo si legge per capire la catena. Sono due atti diversi, con scopi diversi; il secondo è reso difficile dalla pressione del primo, non dal passare del tempo.
Un caso, e cosa è successo tre settimane dopo #
Un contesto bancario, servizio di autorizzazione pagamenti su Oracle in alta affidabilità, carico di picco attorno a 1.400 transazioni al secondo nelle fasce commerciali. Un sabato pomeriggio, per quarantadue minuti, la latenza media del servizio è salita da 180 ms a oltre 2 secondi, con una frazione di transazioni in timeout. Il monitoring ha alertato, il team di reperibilità si è connesso, ha visto un enqueue wait dominante su una tabella di sessione utente. Prima che si decidesse una contromisura, la curva è rientrata. In quarantadue minuti il sistema era di nuovo entro soglia.
Il post-mortem è stato breve. L’ipotesi di lavoro, formulata senza evidenze stringenti, è stata «un pattern di carico anomalo del sabato pomeriggio, forse legato a una campagna commerciale». Il team ha chiuso il ticket, il weekend è ripartito, lunedì il sistema reggeva. (Numeri — carico, latenze, tempistiche — rappresentativi di contesti analoghi; dettagli del caso specifico anonimizzati per riservatezza contrattuale.)
Tre settimane dopo, la stessa combinazione di eventi si è ripresentata — questa volta un giovedì sera, in piena finestra operativa, con un volume di transazioni doppio rispetto al sabato precedente. Il sistema non è rientrato da solo. Il downtime è durato due ore e dieci minuti. Il board ha chiesto una ricostruzione.
A quel punto, con l’urgenza del secondo incident, è stata fatta l’analisi che non era stata fatta a freddo tre settimane prima. L’AWR del sabato aveva, in due snapshot consecutivi, un cambiamento netto nel piano di esecuzione di una query critica — effetto di un ricalcolo di statistiche automatico attivato quando la tabella aveva superato una certa soglia di crescita. L’ASH mostrava la sequenza di sessioni che erano andate in attesa su quella query, con il contatore di waiter che era salito progressivamente fino al punto di innescare l’escalation sulla risorsa interna del database. Il registro dei change mostrava che una nuova release applicativa, quattro giorni prima dell’incident del sabato, aveva introdotto una chiamata aggiuntiva a quella query ogni volta che un utente apriva una sessione — chiamata che diventava critica solo quando il volume di apertura sessione superava una certa concorrenza.
Tutto questo era già nel sistema il sabato pomeriggio. Il thread tra crescita della tabella, ricalcolo statistiche, cambio di piano, nuova release, aumento di concorrenza non era inferibile dai sintomi registrati. Era leggibile da chi avesse messo insieme le fonti con un modello causale in testa — anche due settimane dopo. La differenza non è stata di dati disponibili. È stata di decisione di guardare.
Il TIA è un predittore, non un episodio #
In cardiologia e neurologia preventiva c’è un concetto che vale la pena tenere a mente quando si pensa agli incident che rientrano da soli. Si chiama TIA — Attacco Ischemico Transitorio. È un evento neurologico che si manifesta come un ictus — disturbi di parola, debolezza di un arto, visione offuscata — e rientra spontaneamente nel giro di minuti o ore, senza esiti permanenti. Il paziente al pronto soccorso, se ci va, viene dimesso con esami nella norma e la raccomandazione di controllare la pressione.
Chi conosce i numeri sa che un TIA è uno dei predittori più forti di ictus maggiore nei novanta giorni successivi. La letteratura specialistica indica che circa un paziente su dieci avrà un ictus clinico nei tre mesi successivi al TIA, e la metà di quelli entro quarantotto ore — se non viene fatta la ricostruzione del meccanismo e non viene impostata la prevenzione. Il TIA non è un episodio isolato: è il sistema che ha mostrato una volta, in forma reversibile, come fallirà in forma non reversibile se nessuno interviene sulla causa. (Numeri di riferimento epidemiologici — DA VERIFICARE con linee guida ESO/AHA aggiornate per la citazione pubblica.)
Un incident che rientra da solo ha la stessa natura. Il sistema ha mostrato, in forma reversibile, un meccanismo che — a parità di causa non rimossa — si manifesterà di nuovo. Non necessariamente nello stesso punto, non necessariamente con lo stesso carico, non necessariamente nel sabato pomeriggio di bassa pressione commerciale. Il secondo incident sceglie il momento peggiore con precisione statistica: perché la causa non rimossa continua a lavorare, e perché il carico operativo cresce finché non trova la finestra giusta.
Il TIA e l’incident rientrato condividono anche una seconda caratteristica, più scomoda. Entrambi inducono sollievo. Il paziente dimesso dal pronto soccorso con esami nella norma pensa di averla scampata, non di essere stato avvisato. Il team che vede la curva rientrare pensa che il sistema abbia tenuto, non che il sistema abbia parlato. Il sollievo non è una reazione sbagliata — è umana, legittima, necessaria dopo le ore di tensione. Il momento in cui il sollievo diventa un rischio è quello in cui chiude la finestra di indagine prima che l’indagine sia stata nemmeno aperta.
Le domande che precedono la chiusura del ticket #
Nessuna di queste domande vuole convincere qualcuno a trasformare ogni incident in un progetto di sei settimane. Tutte servono a decidere se un rientro spontaneo chiude il caso o lo apre, prima che venga chiuso per sottrazione.
1. La causa che spiegherebbe sia l’inizio che il rientro spontaneo è stata articolata, oppure stiamo spiegando solo il sintomo? Un incident che inizia perché «c’è stato un pattern di carico anomalo» non spiega il rientro: il carico anomalo non si è spento da solo in quarantadue minuti precisi. Se non c’è un modello causale che renda conto di entrambi gli estremi dell’intervallo, l’indagine non ha chiuso — ha solo smesso di fare domande.
2. Quale fonte conserva ancora tracce dell’incident, e per quanto tempo? AWR, ASH, alert log, log OS, metriche di storage, change log, telemetria applicativa. Ciascuna ha una retention diversa. Mappare la finestra residua di indagine prima di decidere se indagare costa trenta minuti e sposta la decisione dal piano emotivo («ora siamo stanchi») al piano operativo («abbiamo tredici giorni»).
3. Se lo stesso meccanismo si ripresentasse con il doppio del carico, il sistema reggerebbe comunque? È la domanda che un cardiologo esperto pone dopo un TIA. Il sistema ha tenuto una volta in condizioni favorevoli — bassa pressione commerciale, finestra di scarico, concorrenza limitata. La domanda non è «tornerà?». È «quando tornerà, tornerà in condizioni che il sistema può ancora assorbire?». Se la risposta è «non lo sappiamo», l’episodio non è occasionale: è un segnale non ancora letto.
4. Chi avrebbe l’autorità di convocare una ricostruzione a freddo, e con quale finestra temporale? Spesso l’indagine post-rientro non viene aperta non per decisione, ma per assenza di proprietario. Il team operativo è passato al prossimo ticket, l’architetto non ha mandato esplicito, il management ha visto il sistema stabile. Nominare il proprietario della ricostruzione a freddo prima dell’incident successivo è l’intervento organizzativo più sottovalutato — e il più economico — di tutta la governance della resilienza.
Il valore di guardare quando l’urgenza è passata #
C’è un paradosso che vale la pena esplicitare, perché ribalta un’intuizione comune. La ricostruzione a freddo è più accurata, non meno, di quella a caldo — quando le fonti sono conservate. A caldo si cerca con l’ansia di fermare il sintomo, con il board che chiede aggiornamenti ogni dieci minuti, con le ipotesi che si scavalcano. A freddo si legge con il tempo per confrontare fonti diverse, verificare correlazioni, scartare piste che a caldo sembravano salienti e che a freddo si rivelano coincidenze.
Chi ha fatto molte ricostruzioni post-rientro sa anche una seconda cosa: la catena causale che emerge non è quasi mai quella sospettata nel pomeriggio dell’incident. L’ipotesi del «pattern di carico anomalo» è plausibile a caldo, dove tutto quello che è stato visto è una curva anomala. Diventa evidentemente parziale a freddo, quando entrano in gioco il change log della settimana precedente, la crescita della tabella, il ricalcolo statistiche, la nuova release applicativa.
Il costo organizzativo di una ricostruzione a freddo — tre o cinque giornate di tempo di persone esperte, con il sistema già stabile e nessuna urgenza addosso — è una frazione del costo del secondo incident, in giornate di downtime, riunioni di board, conversazioni con i clienti, rinegoziazioni di SLA. Il confronto, per un CFO, si fa in venti secondi. La resistenza, quando c’è, raramente è di budget: è di attenzione. L’organizzazione che ha appena esalato il respiro di sollievo è fisiologicamente poco disposta a trasformare quel respiro in un nuovo ciclo di analisi. È proprio questo il motivo per cui, in molti contesti, conviene che a convocare la ricostruzione sia una figura esterna all’operatività — che non ha vissuto le quarantadue ore di tensione e che può proporre, con calma, di guardare quando guardare costa meno.
Una domanda da portarsi via #
Non c’è una regola universale sugli incident rientrati da soli. C’è, per ogni organizzazione che ne gestisce di critici, una domanda che vale la pena porsi la prossima volta che la curva rientra senza intervento:
«Il meccanismo che spiega come è iniziato spiega anche come è finito — oppure stiamo spiegando solo il fatto che è finito?»
Se la risposta ha qualche esitazione, l’episodio non è ancora occasionale. È un sistema che ha parlato una volta. La seconda volta sceglierà il momento in cui parlare costa di più.
Glossario #
AWR — Automatic Workload Repository — strumento diagnostico integrato in Oracle Database per la raccolta e l’analisi delle statistiche di performance.
ASH — Active Session History — componente Oracle che registra lo stato di ogni sessione attiva una volta al secondo…
wait event — Evento di attesa registrato da Oracle ogni volta che una sessione non può procedere e deve attendere una risorsa — I/O, lock, rete o CPU.
piano di esecuzione — Sequenza di operazioni scelta dall’ottimizzatore SQL per eseguire una query: scansioni, join, ordinamenti. Statistiche obsolete lo degradano silenziosamente.