- Ivan Luminaria/
- Database Strategy/
- Leadership tecnica e progetti/
- Il preventivo dell'upgrade e la domanda che non è istintiva/
Il preventivo dell'upgrade e la domanda che non è istintiva
Più risorse, stessa causa #
Perché aggiungere CPU, RAM o IOPS raramente risolve un database mission-critical che rallenta — e cosa guardare prima di firmare il preventivo.
Il preventivo sul tavolo #
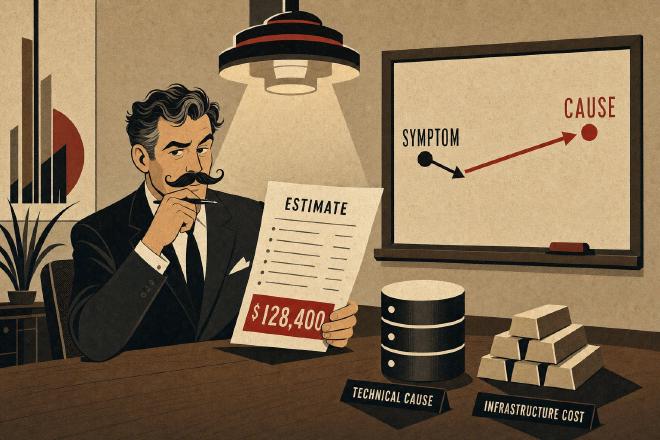
C’è un momento che si ripete quasi identico, in banche, assicurazioni, utility e telco. Un CIO — o un CTO, o un Head of Data Platform — guarda un preventivo per un upgrade infrastrutturale. Può essere una nuova Exadata, una PDB più grande su OCI, una migrazione a un’istanza cloud con più IOPS garantiti, una RAM aggiuntiva su una macchina fisica che non ne aveva più.
Il numero in basso a destra oscilla tra qualche centinaio di migliaia e qualche milione di euro. Il razionale scritto due pagine sopra suona ragionevole: il sistema fatica, il team dice che serve più capacità, il vendor conferma, gli SLA con i clienti enterprise stanno per essere superati. Il board vuole una risposta veloce, il CFO vuole sapere entro quando si firma.
La reazione istintiva, in quel momento, è approvare.
È istintiva per un motivo comprensibile: aggiungere risorse è la decisione più facile da spiegare in venti secondi al comitato di direzione. È misurabile (più giga, più core, più IOPS), è confrontabile (il vendor ti manda il listino), è tracciabile (a fine anno il CFO sa esattamente cosa è stato speso). Dà l’impressione precisa di aver fatto qualcosa.
E in una parte dei casi — probabilmente meno di quanto si creda, ma non zero — funziona davvero. Se il sistema era realmente sotto-dimensionato rispetto al carico, più capacità risolve. Sulla carta è la scelta razionale.
Il problema è cosa succede negli altri casi.
Cosa succede quando non era la causa #
Un database che rallenta è, praticamente sempre, un sintomo. Il sintomo si presenta in un punto preciso: una query notturna che sfora la finestra, un batch analitico che ci mette tre volte tanto, un’applicazione front-end che risponde tardi nelle ore di punta, un incident sporadico che rientra da solo dopo dieci minuti. La causa reale, in un sistema stratificato in dieci o vent’anni, sta quasi sempre un livello più in là rispetto al punto in cui il sintomo appare.
Può essere un piano di esecuzione degradato da una statistica invecchiata. Può essere un modello dati cresciuto più in fretta di come era stato progettato — una tabella diventata da 200 milioni a 2 miliardi di righe con gli stessi indici di dieci anni fa. Può essere una configurazione di storage cambiata sei mesi prima che ha spostato un file su un tier più lento. Può essere una query nuova, introdotta da un’applicazione arrivata l’anno scorso, che scansiona una tabella grossa ogni tre minuti senza che nessuno se ne fosse accorto. Può essere una configurazione RAC che sotto un certo livello di concorrenza scatena wait event trasversali che nel monitoring quotidiano non compaiono.
In tutti questi casi, aggiungere risorse produce un effetto misurabile e temporaneo. Il sistema, con più CPU o più IOPS, riesce a mascherare il collo di bottiglia per settimane, a volte per un paio di mesi. Poi il collo di bottiglia si sposta. Il piano degradato non è cambiato, la tabella cresce ancora, la query mal disegnata continua a girare — e nel frattempo il carico è cresciuto anche lui, come cresce sempre nei sistemi reali. Il sintomo torna, in un punto leggermente diverso, spesso peggiorato dal fatto che ora l’infrastruttura è più costosa da tenere accesa.
Quando succede, la conversazione interna diventa un secondo problema. Perché il CIO che ha appena firmato quel preventivo si trova a spiegare al board che il problema che l’upgrade doveva risolvere è tornato. E il board — legittimamente — fa la domanda che il CIO teme di più: “e adesso? Un altro upgrade?”.
Un caso, e i numeri accanto #
Un esempio concreto, con settore e ordini di grandezza (numeri reali, cliente anonimizzato). Un batch analitico critico in un contesto telco, con Oracle su OCI e Autonomous Database, richiedeva quattro ore ogni notte. Nei tre anni precedenti, la risposta era stata: più CPU, più IOPS, più memoria SGA. A ogni giro il batch scendeva di venti minuti per qualche settimana, poi tornava sulla soglia delle quattro ore. Un’analisi cross-layer — piani di esecuzione, wait event storici in AWR, correlazione con la crescita delle tabelle sorgente, revisione dei join più costosi, riscrittura mirata di tre step del PL/SQL — ha portato il tempo di batch sotto i trenta minuti. Le risorse infrastrutturali sono rimaste quelle di partenza.
In un altro contesto, un Data Warehouse su quattro paesi europei con oltre 60.000 righe di PL/SQL, il pattern era simile: la finestra di ingestion notturna si allungava di trimestre in trimestre, e la richiesta ricorrente era più macchina. Dopo un intervento sul modello dati, sugli indici e sulla riorganizzazione di alcune tabelle di staging, l’ingestion giornaliera completa è rientrata sotto le due ore — senza toccare la parte infrastrutturale.
Il punto non è che l’hardware non serva mai. Il punto è che, quando la causa reale sta nel software, nel modello o nel piano, l’hardware compra tempo. Il tempo è utile — a volte è indispensabile per arrivare fino al prossimo weekend di manutenzione — ma è tempo, non soluzione. E quando lo si compra credendo di aver risolto, il secondo incident arriva nel momento peggiore, con la domanda: “dopo il primo, cosa abbiamo fatto?”.
La riga 330 è ancora lì #
C’è un’immagine che uso spesso, e che chi ha cominciato a programmare quarant’anni fa capisce senza spiegazioni. Il Commodore 64 quando trovava un errore mostrava una scritta gentile: ?SYNTAX ERROR IN 340. Andavi a controllare la riga 340 ed era perfetta. La causa stava nella 330 — un punto e virgola che qualche minuto prima era diventato due punti. (Ho raccontato per esteso quell’esperienza — e come si è trasformata negli anni nel mestiere di oggi — in Il dottore tutto pazzo: un Commodore 64, una porta chiusa e il mestiere di capire.)
Ai bambini di allora quell’esperienza insegnava un principio che oggi vale invariato sui sistemi enterprise: il posto in cui il computer si lamenta non è quasi mai il posto in cui sta l’errore. Aggiungere hardware al posto dove il sistema si lamenta è l’equivalente adulto di modificare la riga 340. Il programma continua a non funzionare, perché la riga 330 sta ancora aspettando.
Nei database mission-critical il meccanismo è lo stesso. Cambiano soltanto le dimensioni. E il costo dell’errore.
Le domande che precedono la firma #
Nessuna di queste domande vuole convincere qualcuno a non firmare un upgrade. In alcuni casi, ripeto, l’upgrade è la risposta giusta e va fatto. Le domande servono a decidere caso per caso se lo è davvero, prima che il preventivo diventi un ordine.
1. Cosa è cambiato nei giorni o nelle settimane che hanno preceduto il primo sintomo? Un sistema che ha funzionato per anni e ora fatica ha, quasi sempre, un evento scatenante. Un patch, una release applicativa, una statistica ricalcolata, una tabella cresciuta oltre una soglia, un cambio di configurazione storage, un nuovo modulo che ha iniziato a chiamare il database in modo diverso. Se la timeline di quel cosa è cambiato non è ricostruita in modo credibile, l’upgrade sta comprando tempo su una causa ancora ignota.
2. Quale evidenza tecnica sostiene l’ipotesi che serve più capacità? Un AWR con evidenza chiara che i wait event dominanti siano CPU-bound o I/O-bound sostiene un upgrade. Un ASH che mostra sessioni bloccate su lock applicativi, o un piano di esecuzione degradato che fa un full scan su una tabella indicizzabile, indica un’altra strada. La differenza si legge nei dati, non nelle sensazioni.
3. Chi, dentro il team o al fianco del team, sta guardando il sistema per intero? Il DBA vede il database, lo sviluppatore vede l’applicazione, il sistemista vede l’infrastruttura, il team di rete vede la rete. Ognuno vede correttamente il proprio pezzo. La causa reale, quando è trasversale, sta nell’intreccio — e nessuno di questi ruoli, per definizione, ha visibilità completa sull’intreccio. La domanda “chi legge il sistema per intero?” non è retorica: se la risposta è “nessuno in modo strutturato”, l’upgrade sta decidendo prima di aver capito.
4. Se l’upgrade funzionasse solo per tre mesi, quale sarebbe il piano B? È la domanda che i CIO più esperti pongono per ultima. Se la risposta è “ne faremo un altro”, la strategia è chiara e vale il rischio. Se la risposta è “non lo abbiamo pensato”, conviene fermarsi un momento.
Il confronto che il CFO capisce in trenta secondi #
Un Health Check strutturato — cinque giornate di analisi cross-layer, un report con timeline, evidenze e roadmap con priorità — ha un costo che è un ordine di grandezza inferiore al preventivo medio di un upgrade infrastrutturale enterprise (indicativamente €8K per il Health Check contro €300K–€500K di un upgrade Exadata di dimensione media — cifre di riferimento DA VERIFICARE rispetto a listini specifici del cliente).
La logica per un CFO è lineare: prima di firmare una spesa di sei zeri, un secondo parere indipendente costa una frazione del preventivo e riduce la probabilità di firmare due volte per lo stesso problema. Non è uno sconto sulla spesa infrastrutturale — è un’assicurazione sul fatto che, quando la firma arriva, arriva sulla decisione giusta.
Il valore per il CIO è ancora più diretto: porta al board una decisione difendibile. “Abbiamo commissionato un’analisi indipendente, abbiamo confrontato le sue conclusioni con la proposta del vendor, la scelta finale è coerente con entrambe” è una frase che chiude il punto in tre righe di verbale. “Abbiamo firmato perché il vendor lo suggeriva” apre un altro tipo di conversazione — quella che il CIO preferisce non avere sei mesi dopo, se il problema torna.
Una domanda da portarsi via #
Non c’è un principio universale sull’upgrade infrastrutturale. Ci sono contesti in cui è la scelta corretta e va fatta senza esitare; ce ne sono altri in cui è un tempo comprato caro. La differenza non sta nella tecnologia né nel vendor. Sta nella qualità della diagnosi che precede la firma.
Se un preventivo importante è sul tuo tavolo in queste settimane, c’è una domanda che vale la pena porsi prima di approvare:
“L’analisi che sostiene questa spesa distingue in modo credibile tra la causa reale del rallentamento e il punto in cui il rallentamento si manifesta — oppure sta assumendo che coincidano?”
Se la risposta ha qualche esitazione, la riga 330 potrebbe essere ancora lì.