- Ivan Luminaria/
- Database Strategy/
- Leadership tecnica e progetti/
- L'AI mostra il sintomo. Il board chiede la causa./
L'AI mostra il sintomo. Il board chiede la causa.
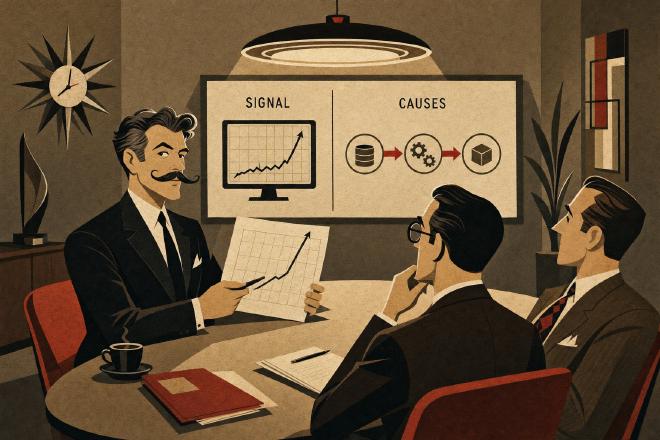
L’AI mostra il sintomo. Il board chiede la causa. #
Cosa fa, davvero, l’observability moderna — e cosa serve ancora, quando la domanda arriva dal piano di sopra.
La domanda del lunedì mattina #
C’è una domanda che un CIO conosce bene, e che arriva quasi sempre nelle ventiquattro ore successive a un incident serio. La fa il board, la fa il CFO, a volte la fa l’amministratore delegato in corridoio. Suona così, con piccole variazioni: «ma non avevamo preso Datadog l’anno scorso? Non avevamo rinnovato Dynatrace? Non avevamo attivato Ops Insights su OCI? Allora come è possibile che non ci abbia avvisato?».
La risposta onesta è scomoda, perché richiede di dire due cose contemporaneamente. La prima: lo strumento ha funzionato. Il grafico era lì, le metriche erano registrate, gli alert erano configurati. La seconda: lo strumento non ha capito cosa stava succedendo, perché capire non era il suo mestiere. Il suo mestiere era mostrare. Ha mostrato — regolarmente, con precisione. Nessuno, nel team, ha letto quello che mostrava come segnale di una catena che si stava componendo.
Chi presenta il bilancio al board, in quel momento, ha due strade. Può lasciare che la narrativa diventi «lo strumento ci ha deluso» — e tornare dal procurement con la richiesta di un altro strumento, forse più costoso, forse con più intelligenza artificiale dichiarata nel materiale commerciale. Oppure può prendersi un pomeriggio per spiegare al board cosa fa e cosa non fa, davvero, l’observability moderna di cui si è dotato. La seconda strada è più faticosa, ma restituisce al CIO il controllo della narrazione — che è la cosa che il board sta davvero cercando quando pone quella domanda.
Cosa mostra uno strumento, cosa ricostruisce una persona #
Datadog, Dynatrace, Grafana, Splunk, New Relic, OCI Ops Insights, Oracle Cloud Observability sono — ciascuno con la propria qualità, che è reale — straordinari raccoglitori di segnali. Registrano decine di migliaia di metriche al secondo, correlano serie temporali, applicano modelli statistici che individuano anomalie con un livello di precisione impensabile dieci anni fa. In molti scenari il valore che aggiungono è altissimo: alert operativi che arrivano prima di una saturazione prevedibile, dashboard che consolidano in una vista unica quello che prima richiedeva otto console separate, baseline che riconoscono il comportamento normale di un sistema e segnalano quando ne esce.
Il punto in cui questi strumenti smettono di sostituire una persona non è un limite di qualità del prodotto — è un limite strutturale del tipo di informazione che restituiscono. Un grafico mostra che la CPU è salita, che la latenza del disco è aumentata, che un wait event è diventato dominante, che una query ha cambiato piano di esecuzione. Un modello di AIOps, nei casi più sofisticati, segnala che tre o quattro di questi fenomeni sono correlati nel tempo. La correlazione non è la catena causale. La catena causale è una storia: un pacchetto di statistiche è stato ricalcolato il 14 settembre alle 02:17 dalla job notturna, il nuovo piano di esecuzione per la query X ha iniziato a scansionare in full una tabella cresciuta a 1.8 miliardi di righe nei tre mesi precedenti, la contesa su enqueue application lock è emersa quando la nuova release applicativa — rilasciata il 16 — ha iniziato a chiamare quella query ogni venti secondi invece che ogni cinque minuti, lo spike di CPU che il monitoring ha segnalato il 17 è la conseguenza di tre eventi che il monitoring non ha messo in relazione tra loro perché nessuno gli aveva chiesto di cercare questo tipo di storia.
Questa storia non la racconta uno strumento. La ricostruisce una persona che sa cosa cercare — perché ha letto migliaia di catene simili, su sistemi simili, in dieci o venti anni di mestiere. Lo strumento gli fornisce i dati di partenza. Senza lo strumento, la ricostruzione sarebbe più lenta. Senza la persona, non ci sarebbe.
Un caso, e il grafico accanto #
Un contesto telco italiano, Oracle su OCI, batch analitico critico che alimenta una serie di dashboard commerciali. L’observability era moderna, l’investimento recente, l’AIOps attivo. Per sei settimane consecutive, il batch — che storicamente completava in due ore e mezza — ha iniziato a sforare prima verso le quattro, poi verso le cinque. Lo strumento segnalava regolarmente: anomalia su CPU wait, crescita I/O read, aumento della latenza di storage sul tier 1. Tre anomalie distinte, correlate temporalmente, nessuna identificata come causa prima — perché nessuna lo era.
Il team ha speso tre settimane dietro a ciascuna anomalia singolarmente. Più CPU al nodo, verifica dello storage con il fornitore cloud, ottimizzazione delle sessioni concorrenti. Ogni intervento ha prodotto un miglioramento di quindici o venti minuti sul tempo di batch, poi la curva è tornata a salire. Nessuno dei tre interventi era sbagliato in sé: ciascuno rispondeva a una delle anomalie segnalate dallo strumento. Nessuno dei tre era la risposta, perché la risposta non stava in nessuna delle tre anomalie prese singolarmente.
Un’analisi cross-layer durata cinque giornate ha ricostruito la catena. Un piano di esecuzione degradato tre mesi prima a causa di una statistica che aveva perso rappresentatività su una tabella cresciuta di un ordine di grandezza; una modifica di configurazione sul PGA fatta in un ticket urgente a maggio e mai documentata; una query nuova introdotta da un’applicazione front-end a inizio luglio, che apriva una concorrenza inaspettata su una struttura di lock interna del database. Tre eventi distanti nel tempo, documentati in tre sistemi diversi (il repository DBA, il wiki infrastrutturale, il release manager applicativo), nessuna correlazione automatica possibile tra di loro per uno strumento di observability — perché erano eventi di natura, periodo e sistema diversi.
Il batch, dopo la revisione congiunta del piano, dell’indicizzazione mirata e del rollback della modifica PGA, è rientrato stabilmente sotto i trenta minuti. Lo strumento di observability, da quel momento, è diventato molto più utile — perché il team ha iniziato a leggere i suoi grafici con una mappa in testa. (I numeri — 800 milioni di record/giorno, SLA sotto i 500 ms sul servizio downstream — restano quelli dichiarati in altri interventi su contesti analoghi; il dettaglio operativo di questo specifico caso è anonimizzato per riservatezza contrattuale.)
L’elettrocardiogramma è un dato, non una diagnosi #
C’è un’immagine che aiuta, soprattutto con un board che non è tecnico ma ha visto almeno una volta un pronto soccorso. Un elettrocardiogramma registra con precisione il ritmo del cuore. Riconosce aritmie, segnala extrasistoli, mostra la frequenza istantanea con un livello di dettaglio che un medico di cinquant’anni fa avrebbe considerato fantascienza. È uno strumento diagnostico eccezionale.
Non vede la carotide ostruita. Non vede un embolo che si sta formando in una vena profonda. Non vede un aneurisma asintomatico. Il paziente può avere un ECG impeccabile e un ictus trenta secondi dopo. Non è un difetto dell’ECG — è la natura dell’ECG: registra una funzione precisa, non tutte le funzioni del paziente. Il medico lo sa, e usa l’ECG come uno degli esami, mai come la diagnosi. L’anamnesi, l’esame obiettivo, altri esami mirati sulla base del sospetto clinico, la storia del paziente negli anni: tutte queste cose insieme ricostruiscono il quadro.
Un sistema mission-critical ha la stessa natura di un paziente complesso. L’observability moderna è l’ECG — eccezionale per quello che fa, cieca per quello che non vede. L’AIOps è un ECG che evidenzia automaticamente le aritmie, utile. La diagnosi resta un atto umano, e lo resta non per nostalgia del passato ma per la struttura stessa del problema: la catena causale di un sistema stratificato in vent’anni richiede di tenere insieme repository DBA, change log infrastrutturali, release note applicative, tracce di sistema operativo, pattern di carico, modifiche al modello dati. Nessuno strumento, oggi, ha accesso simultaneo a tutte queste fonti con la capacità di leggerle insieme — e non per limiti dei prossimi diciotto mesi, ma per come è fatto il problema.
Le domande che precedono la fiducia nello strumento #
Nessuna di queste domande vuole convincere qualcuno a disinstallare l’observability — tutte servono a usarla per quello che è, con la giusta aspettativa dal board al team operativo.
1. Lo strumento vede tutti i livelli che compongono il sistema, o solo quelli su cui è stato installato il collector? Datadog APM copre magnificamente le applicazioni istrumentate; se un pezzo del flusso critico passa su un servizio legacy senza agent, lo strumento ha un buco. Non è un difetto: è una scelta di perimetro di cui spesso ci si dimentica dopo i primi sei mesi di uso.
2. Chi, nel team, interpreta gli alert — e in base a quale modello mentale del sistema? Un alert che dice «CPU wait anomalo sul nodo 2» significa cose diverse per un sistemista, un DBA e uno sviluppatore. Se non c’è una convenzione interna su chi interpreta cosa, lo strumento genera rumore, il team impara a ignorare le notifiche, e il valore si perde senza che nessuno se ne accorga.
3. Quando lo strumento ha segnalato un’anomalia che si è rivelata un sintomo di una causa più profonda, qualcuno ha scritto cosa era successo? La memoria organizzativa degli incident è spesso più povera della memoria dello strumento. Un runbook post-mortem che collega «l’alert X era in realtà il sintomo della catena Y» vale, nel medio periodo, più di un upgrade del tier dello strumento.
4. Se lo strumento mostrasse metriche nel verde per sei settimane consecutive, cosa controlleresti comunque? È la domanda che un medico di famiglia esperto porrebbe a un paziente con esami tutti nella norma ma stanco da troppo tempo. Un sistema può avere tutti i grafici verdi e stare preparando il collasso: una coda silenziosa di sessioni in wait su una struttura di lock, una tabella che cresce fuori modello, una procedura che va in loop ogni primo lunedì del mese e si risolve prima dell’alert threshold. Il verde è una buona notizia, non una garanzia.
Cosa chiede davvero il board #
La domanda del board — «perché lo strumento non ci ha avvisato?» — nasconde quasi sempre un’altra domanda, più scomoda da porre esplicitamente: «chi, qui dentro, sta leggendo il sistema per intero, oltre al proprio pezzo?». Quando la risposta è «in modo strutturato, nessuno», lo strumento diventa la cosa più semplice da indicare come insufficiente. È comprensibile, ed è anche una buona occasione di conversazione — perché la risposta vera non è «prendiamo uno strumento più intelligente», è «assicuriamoci che qualcuno, con il tempo e il mandato, stia leggendo gli strumenti che già abbiamo con il quadro completo in mente».
Quel qualcuno può essere interno — un senior con il perimetro giusto, protetto dal rumore operativo, con l’autorità di parlare al board quando serve. Può essere affiancato dall’esterno in forma continuativa, come riscontro indipendente. In alcuni momenti — una ricostruzione post-incident, un dubbio su un preventivo di piattaforma — può essere portato dall’esterno in forma mirata, con un mandato preciso e circoscritto. Nessuna di queste tre strade richiede di sostituire lo strumento di observability: tutte e tre lo rendono finalmente utile per quello che è, un alleato diagnostico che ha bisogno di un lettore competente.
Una domanda da portarsi via #
Non c’è un principio universale sull’observability. C’è, per ogni organizzazione che ne ha una matura, una domanda che vale la pena porre al prossimo post-mortem:
«Lo strumento ha mostrato in tempo reale quello che è successo — e nelle due settimane precedenti qualcuno aveva letto quei grafici con un modello causale in testa, oppure ciascuno guardava il proprio pezzo?»
Se la risposta ha qualche esitazione, la prossima volta che il board chiederà «ma non avevamo preso Datadog?», la conversazione sarà più semplice da fare — perché la risposta non sarà sul vendor, ma su quello che abbiamo imparato a leggere nel frattempo.
Ivan Luminaria è Technical Leader per database mission-critical. Lavora con CIO, CTO e IT Director di banche mid-tier, assicurazioni, telco, utility e grandi PA italiane con un metodo di lettura cross-layer costruito in quasi trent’anni di sistemi reali.
Glossario #
wait event — Evento di attesa registrato da Oracle ogni volta che una sessione non può procedere e deve attendere una risorsa — I/O, lock, rete o CPU.
piano di esecuzione — Sequenza di operazioni scelta dall’ottimizzatore SQL per eseguire una query: scansioni, join, ordinamenti. Statistiche obsolete lo degradano silenziosamente.