- Ivan Luminaria/
- Database Strategy/
- Oracle/
- Oracle 11g R2 → 19c su OCI: 8 TB in finanza, un piano di upgrade con fasi e rollback/
Oracle 11g R2 → 19c su OCI: 8 TB in finanza, un piano di upgrade con fasi e rollback
Oracle 11g R2 → 19c su OCI: 8 TB in finanza, un piano di upgrade con fasi e rollback #
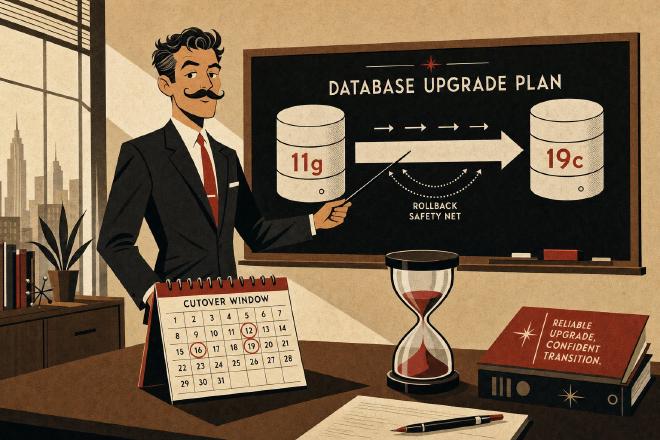
Come smontare la paralisi decisionale su un’istanza Oracle 11g EOL ancora in produzione, scegliere la strategia di upgrade giusta per 8 TB cloud-to-cloud e portare il cutover in quattro ore con rollback pronto a ogni passo.
Un’istanza che nessuno voleva toccare #
C’è un pattern che chi lavora da anni con sistemi finanziari conosce bene. Un’istanza Oracle 11g Release 2 — nel caso specifico la 11.2.0.4, ultima minor di tutta la famiglia 11g, rilasciata nel 2013 — è ancora accesa in produzione nel 2026. Sopra ci gira un sistema di middle-office per il controllo dei limiti di esposizione intraday, costruito negli anni dieci sopra PL/SQL complesso, con 420+ package e procedure, 1.400 oggetti applicativi, e una logica di posting contabile che si è stratificata su più release di business. Il database pesa 8 TB e cresce di qualche centinaio di GB l’anno. Gira su un’istanza OCI VM.Standard dedicata, migrata al cloud quattro anni prima con un lift-and-shift pulito.
Oracle ha dichiarato il Premier Support per 11g concluso a gennaio 2015, l’Extended Support concluso a dicembre 2020. Da quasi sei anni l’istanza non riceve patch di sicurezza, nessun fix di bug maggiore, nessuna CPU trimestrale. Negli audit interni degli ultimi tre anni l’istanza è sistematicamente classificata come «rischio alto», ma non è mai successo un incident grave abbastanza da forzare la decisione. Nel frattempo il framework di compliance è cambiato: DORA è entrato in vigore, Banca d’Italia ha affinato le proprie expectations su supportabilità delle infrastrutture critiche, i revisori esterni hanno iniziato a chiedere piani di remediation con date.
Perché l’istanza era ferma a 11g? Non per mancanza di competenza tecnica — il team interno sapeva come si fa un upgrade. Era ferma per paralisi decisionale. L’applicazione sopra era critica (fermarla significava che i trader non vedevano i propri limiti di esposizione in tempo reale), la finestra di downtime difendibile al business era al massimo di quattro ore una notte di sabato, nessuno dei vendor applicativi coinvolti era più disponibile per supporto, e nessuno nel team interno voleva mettere la firma sotto una procedura di upgrade che toccava il cuore del posting contabile. Era un classico caso di «finché gira, non si tocca» — comprensibile, legittimo, insostenibile.
Quando la decisione non si può più rimandare #
A un certo punto la bilancia dei rischi si è invertita. Il rischio di una vulnerabilità non patchable è diventato più grosso del rischio del cutover. Il risk committee ha chiesto un piano con date certe e rollback dimostrabile. Il piano è stato proposto in sei settimane di studio, discusso in due riunioni col business, approvato con l’impegno formale di lasciare la vecchia istanza in sola lettura per due settimane dopo il cutover, in caso servisse tornare indietro.
Il target è stato scelto 19c (19.24) — non 21c, non 23ai. Due ragioni. La prima: 19c è la Terminal Release del branch 12.2, il che significa in gergo Oracle che è la release destinata a Long-Term Support (Premier Support fino al 2027, Market-Driven Support fino al 2032). È la versione più stabile e meglio documentata del momento, con un ecosistema di patch set maturo. La seconda: 19c è il minimo compatible target per un upgrade diretto da 11.2.0.4 (direct upgrade è supportato: nessun hop intermedio necessario via 12c). Saltare direttamente a 21c o 23ai avrebbe richiesto un hop multi-release più lungo e un rischio di stabilità post-migrazione maggiore, con poco guadagno funzionale per un’applicazione legacy.
Le opzioni tecniche sul tavolo #
Per un database Oracle di 8 TB che fa da storage a un applicativo mission-critical con una finestra di cutover di quattro ore, le strategie realistiche sono cinque. Vale la pena articolarle insieme, perché la scelta è un trade-off di tempo di prep, downtime effettivo, complessità di rollback e costo di licensing degli strumenti ausiliari.
| Strategia | Downtime | Prep | Rollback | Note |
|---|---|---|---|---|
| DBUA in-place (direct 11.2.0.4 → 19c) | 6-12 ore su 8 TB | Giorni | Difficile (restore backup) | Supportato ma troppo downtime per il caso |
| Data Pump expdp/impdp full | 10-20 ore su 8 TB | Giorni | Facile (vecchia istanza intatta) | Lento, ma pulito. Troppo downtime |
| Transportable Tablespaces (TTS) + Data Pump metadata | 4-6 ore su 8 TB | 1 settimana | Facile | Copia iniziale lunga, cutover accettabile |
| Cross-Platform Transportable Tablespaces con Incremental Backups (XTTS) | 2-4 ore su 8 TB | 2 settimane in parallelo | Facile (RO sulla sorgente) | Scelto — minimizza cutover a costo di prep lunga |
| Oracle Zero Downtime Migration (ZDM) | 10-30 minuti | 3-4 settimane + licensing | Automatizzato | Opzione premium, scartata per costo tool + complessità setup |
La scelta è caduta su XTTS con incremental backups. Permette di spezzare l’upgrade in due fasi distinte: una lunga ma invisibile al business (prep di due settimane di copia e sincronizzazione) e una corta e visibile (cutover di quattro ore nella notte del sabato). Il metodo è documentato da Oracle in MOS Note 2471245.1 ed è il più usato in produzione per database di grossa dimensione cross-version e cross-platform. Il rollback resta semplice perché la sorgente non viene toccata — resta in produzione fino al momento del cutover, e torna attivabile in trenta minuti anche dopo.
Il piano, in sei fasi #
Fase 0 — Assessment (2 settimane prima del cutover) #
Esecuzione di preupgrd.sql (il tool di pre-upgrade distribuito con 19c, da eseguire sulla sorgente 11.2.0.4 dopo averlo copiato dal download di 19c) + autoupgrade.jar in modalità analyze. L’output è un report che elenca:
- Oggetti invalid da rimediare prima dell’upgrade
- Parametri
init.oradeprecati (classici in 11g:background_dump_dest,user_dump_dest,plsql_v2_compatibility) - Feature deprecate usate dall’applicativo (il più comune:
LONGeRAWtypes, da verificare se l’app ha dependency) - Statistiche obsolete su tabelle grandi
- Password con hashing debole (11g accettava default
DES, 19c richiedeSHA-2)
Nel caso in questione il report ha segnalato 23 oggetti invalid (quasi tutti procedurali, risolvibili con una ricompilazione), 7 parametri deprecati nel spfile, e nessun uso di LONG/RAW nel codice applicativo (verificato via dba_tab_columns). Due settimane sono bastate per sistemare tutto senza fretta.
Fase 1 — Build dell’ambiente 19c target su OCI #
In parallelo al Fase 0, provisioning di una nuova istanza OCI con 19c (19.24 RU trimestrale corrente), stessa shape della sorgente ma con storage NVMe locale per performance di import, non network block volume. Installazione pulita, configurazione network, listener, service name identici alla sorgente (per minimizzare il cambio applicativo al cutover). I tablespace USER vengono creati vuoti con la stessa topologia della sorgente — stessi nomi, stesse size iniziali, stessa estensione. I tablespace di sistema (SYSTEM, SYSAUX, UNDO, TEMP) sono quelli nativi 19c, non quelli trasportati.
Fase 2 — Initial RMAN backup level 0 + rollforward iniziale (giorni 1-7 di prep) #
Backup incrementale level 0 di tutti i tablespace USER della sorgente, in formato backupset, tramite RMAN con parallelism alto (CONFIGURE DEVICE TYPE DISK PARALLELISM 8). Trasferimento sul target via Object Storage OCI (bucket condiviso tra le due istanze — latenza bassa, nessun hop internet). Rollforward iniziale sul target 19c tramite convert cross-version (RMAN> CONVERT DATAFILE ... TO PLATFORM 'Linux x86 64-bit' se cross-platform, oppure semplice restore se stessa platform).
Durata: ~5-6 giorni per 8 TB con quella shape di storage. L’operazione è completamente in background, nessun impatto sulla sorgente produttiva.
Fase 3 — Incremental backup level 1 ciclici (giorni 7-14 di prep) #
Da quel momento, RMAN incrementale level 1 ogni 4 ore sulla sorgente (BACKUP INCREMENTAL LEVEL 1 FOR RECOVER OF COPY WITH TAG 'xtts_incr' ...). Trasferimento continuo sul target, rollforward applicato sul target. Il lag tra sorgente e target rimane sotto le 6 ore per tutta la settimana precedente al cutover. Monitoring con script dedicati che tracciano SCN delle due istanze.
Fase 4 — Pre-cutover testing (weekend prima del go-live) #
In un ambiente di staging — copia completa dell’applicazione e del database — simulazione completa della procedura di cutover. Validazione dell’applicativo con endpoint 19c, smoke test di tutti i batch notturni, test di tutti gli online service che chiamano stored procedure complesse. Correzione di quattro differenze di comportamento emerse (nessuna grave: una ORA-29913 su una external table che aveva un path assoluto hardcoded, due query con hint deprecati, un DBMS_SCHEDULER job con un parametro che aveva cambiato formato).
Fase 5 — Cutover notturno (sabato notte, 4 ore) #
| Ora | Azione |
|---|---|
| T−00:30 | Comunicazione al team business: freeze imminente |
| T+00:00 | SHUTDOWN IMMEDIATE dell’applicativo (stop writes sulla sorgente) |
| T+00:10 | Ultimo RMAN incremental level 1 sulla sorgente |
| T+00:40 | Apply dell’ultimo incremental sul target 19c |
| T+01:00 | Sorgente 11g messa in READ ONLY tutti i tablespace USER |
| T+01:10 | Export metadata via Data Pump (expdp TRANSPORT_TABLESPACES=...) — tutti i tablespace USER + users + grants + public synonyms + sequences + views + packages + triggers + jobs |
| T+01:40 | Trasporto fisico dei datafile USER dalla sorgente al target (metadata already applied) + import metadata su 19c (impdp TRANSPORT_DATAFILES=... TRANSPORT_TABLESPACES=... REMAP_SCHEMA=... se necessario) |
| T+02:30 | ALTER TABLESPACE ... READ WRITE sul target + UTL_RECOMP.RECOMP_PARALLEL per ricompilare invalid objects |
| T+03:00 | Smoke test di tutti i servizi applicativi contro il nuovo endpoint 19c |
| T+03:30 | Switch del service name DNS applicativo (TTL abbassato preventivamente a 60 secondi) sul nuovo endpoint |
| T+04:00 | GO-LIVE |
Fase 6 — Il piano di rollback (le due settimane dopo il go-live) #
Due reti di sicurezza, in ordine di invasività crescente:
Rete 1 — Switch DNS indietro: la vecchia 11g rimane accesa in sola lettura per 14 giorni. In caso di problemi gravi irrisolvibili nelle prime ore, è sufficiente rimettere READ WRITE sui tablespace sorgente (operazione di pochi secondi) e switchare indietro il service name DNS. L’applicativo torna a parlare con la 11g in meno di 30 minuti, perdendo al massimo i dati scritti sul 19c dopo il cutover (quantificabili e recuperabili via Data Pump dal 19c alla 11g, se serve). Costo di questa rete: tenere l’istanza 11g accesa per due settimane in più.
Rete 2 — Snapshot OCI: snapshot a blocchi dell’istanza 19c prima del cutover + snapshot della 11g con l’ultimo stato RW. In caso di catastrofe durante il cutover stesso (es. corruzione del metadata durante l’import), restore degli snapshot in 1-2 ore. Rete di sicurezza raramente necessaria, ma dà serenità al risk committee quando si approva il piano.
Dopo il go-live #
Il primo lunedì mattina è il momento critico. L’apertura di mercato porta la prima ondata di carico reale su un’istanza 19c che fino a quel momento aveva visto solo il test di sabato notte. Il monitoring attento delle prime 48 ore è focalizzato su tre aspetti:
- Piani di esecuzione cambiati: 19c introduce un cost-based optimizer significativamente diverso da 11g — Automatic SQL Plan Management, Statistics Advisor più aggressivo, nuovi algoritmi di join. Nel caso in questione, su 420+ package applicativi, 11 query critiche hanno cambiato piano con regressione di performance. Risolti in 48 ore con hint mirati (
USE_NL,INDEX) oSPM baselinecatturate dal piano precedente eseguito in staging. - Statistiche: raccolta completa post-upgrade con il nuovo optimizer 19c, non riuso dei valori 11g, che sarebbero obsoleti su strutture di memoria differenti. Operazione pesante (ore) ma necessaria.
- AWR comparison: snapshot AWR per 48 ore pre-cutover sulla 11g e per 48 ore post-cutover sulla 19c, confronto con
DBMS_WORKLOAD_REPOSITORY.AWR_DIFF_REPORT_HTML. Nessuna degradazione sistemica, miglioramento netto su alcune query batch (il 19c ha un adaptive join che l'11g non aveva).
Dopo 14 giorni, con zero rollback necessari e metriche stabili, la vecchia 11g è stata spenta e archiviata (snapshot preservato per 90 giorni per audit, poi retention normale). Il risk committee ha chiuso il punto nella sua agenda per la prima volta in cinque anni.
Cosa portarsi via, se si è nella stessa situazione #
Un upgrade da 11g a 19c non è un’operazione tecnica complicata — è un’operazione politicamente complicata. La tecnica è nota, documentata, ripetuta in migliaia di implementazioni. Quello che blocca davvero le istanze EOL in produzione è la combinazione di: applicativo critico senza vendor di supporto attivo, finestra di downtime stretta, assenza di una procedura di rollback dimostrabile che permetta a chi firma di dormire la notte dopo il cutover.
Tre domande valgono la pena di essere poste, se stai valutando un upgrade analogo:
1. Qual è il massimo downtime applicativo difendibile davanti al business, e quale strategia tecnica rientra in quella finestra? Se la risposta è «al massimo quattro ore in una notte di sabato», XTTS con incremental è quasi obbligato per database oltre i 2-3 TB. Se la risposta è «al massimo dieci minuti», ZDM è l’unica opzione realistica — e va budgetato il tool.
2. Qual è il piano di rollback, misurato in minuti? Un piano di rollback che richiede «restore completo dal backup» non è un piano di rollback, è una speranza. Un piano serio è «service name DNS switch indietro in 30 minuti con la vecchia istanza accesa in sola lettura». La differenza, davanti al risk committee, è tutto.
3. Chi firma la procedura di cutover, e cosa serve a quella persona per firmare? Nei casi reali che ho visto, il blocco non è mai tecnico — è la ricerca di quella firma. Quando il piano include rollback misurabile, snapshot pre-cutover, pre-test completo su staging, la firma arriva. Senza quegli elementi, il piano resta nel cassetto per anni.
Un’istanza 11g in produzione nel 2026 non è un errore — è un sintomo. Il piano di upgrade non è solo tecnica: è il momento in cui si rimette in moto una decisione che era rimasta ferma per anni.
Ivan Luminaria è Technical Leader per database mission-critical. Lavora con CIO, CTO e IT Director di banche mid-tier, assicurazioni, telco, utility e grandi PA italiane con un metodo di lettura cross-layer costruito in quasi trent’anni di sistemi reali.
Glossario #
XTTS (Cross-Platform Transportable Tablespaces)
cutover — Momento critico di una migrazione in cui il sistema di produzione viene spostato definitivamente dalla vecchia alla nuova infrastruttura.