- Ivan Luminaria/
- Database Strategy/
- MySQL/
- InnoDB buffer pool: dimensionamento, hit ratio e warm-up dopo restart/
InnoDB buffer pool: dimensionamento, hit ratio e warm-up dopo restart
128 MB su una macchina da 32 GB #
L’alert è arrivato un giovedì mattina: latenza media delle query in salita, picchi oltre i 100ms su operazioni che in teoria dovevano essere veloci. Un’applicazione e-commerce, MySQL 8.0, server con 32 GB di RAM. Il team aveva già guardato gli indici, già rivisto le query più lente, già aggiunto qualche EXPLAIN. Tutto sembrava ragionevole sulla carta.
Poi qualcuno ha guardato innodb_buffer_pool_size.
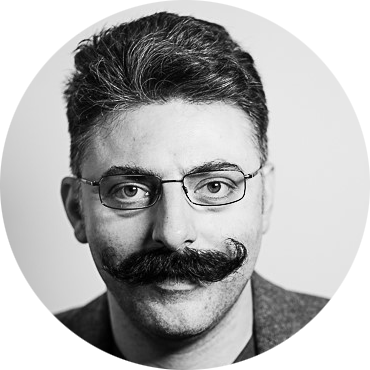
128 MB. Il valore di default. Su una macchina con 32 GB di RAM disponibili, MySQL stava usando 128 MB come cache per i dati InnoDB. Il 95% delle letture finiva su disco. L’hit ratio del buffer pool era sotto il 50%.
Non era un problema di query. Era un problema di configurazione di base che nessuno aveva mai toccato dal provisioning iniziale.
Cosa fa il buffer pool, davvero #
Il buffer pool è la struttura di memoria centrale di InnoDB. Quando MySQL legge una pagina da disco — che sia una riga di una tabella, un nodo di un indice B-tree, o dati di undo — la carica in memoria nel buffer pool. Le letture successive della stessa pagina vengono servite dalla RAM, non dal disco. Quando si scrive, InnoDB modifica prima la pagina in memoria (pagina “dirty”) e poi la sincronizza su disco in background tramite il meccanismo di flush.
La struttura interna usa una variante dell’algoritmo LRU (Least Recently Used): le pagine più recentemente accedute restano in cima, quelle meno usate vengono evicted per fare spazio alle nuove. InnoDB implementa una versione a due zone — una “young list” per le pagine accedute di recente e una “old list” per quelle candidate all’eviction — per evitare che full scan di grandi tabelle buttino fuori dalla cache le pagine calde [1].
Le pagine dirty vengono scritte su disco dal thread di flush in background. Il parametro innodb_io_capacity controlla quante operazioni di I/O al secondo InnoDB può usare per questo scopo. Se il buffer pool è troppo piccolo, il tasso di eviction è alto, le pagine dirty vengono flushate continuamente, e il disco diventa il collo di bottiglia anche su hardware veloce.
Con 128 MB di buffer pool e tabelle che nel complesso occupano diversi GB, ogni query che tocca dati non recenti finisce su disco. Su un e-commerce con pattern di accesso distribuiti su catalogo prodotti, ordini, sessioni utente, il risultato è esattamente quello che il team stava vedendo: latenza alta, I/O saturo, CPU relativamente tranquilla.
La regola del 70-80% — e quando non applicarla #
La raccomandazione standard per un server dedicato a MySQL è di assegnare al buffer pool tra il 70% e l'80% della RAM disponibile [2]. Su 32 GB, questo significa tra 22 e 26 GB. Nel caso in questione, siamo arrivati a 24 GB — circa il 75%.
-- Verifica il valore corrente
SHOW VARIABLES LIKE 'innodb_buffer_pool_size';

-- Modifica a runtime (MySQL 5.7.5+, InnoDB dynamic resize)
SET GLOBAL innodb_buffer_pool_size = 25769803776; -- 24 GB in byte
Da MySQL 5.7.5 in poi, il resize del buffer pool avviene online senza restart, anche se l’operazione non è istantanea: InnoDB ridimensiona il pool a chunk, e durante il processo c’è un leggero impatto sulle performance. Vale la pena farlo in una finestra di bassa attività la prima volta, poi il valore va nel file di configurazione.
# /etc/mysql/mysql.conf.d/mysqld.cnf
[mysqld]
innodb_buffer_pool_size = 24G
La regola del 70-80% vale per server dedicati. Se la macchina ospita anche l’applicazione, un web server, o altri processi con footprint di memoria significativo, bisogna scendere. Un sistema che va in swap per colpa del buffer pool è peggio di un buffer pool piccolo: lo swap su disco è molto più lento di qualsiasi I/O di database normale.
Buffer pool instances: la contesa sui mutex #
Con un buffer pool grande, un secondo parametro entra in gioco: innodb_buffer_pool_instances.
Il buffer pool è protetto da mutex interni. Su sistemi con molti thread concorrenti, un singolo pool grande diventa un collo di bottiglia per la contesa su questi lock. La soluzione è suddividere il pool in istanze indipendenti, ognuna con il proprio set di mutex e la propria LRU list [3].
La regola pratica: una istanza per ogni GB di buffer pool, fino a un massimo di 64. Per 24 GB, 8 istanze è un punto di partenza ragionevole.
[mysqld]
innodb_buffer_pool_size = 24G
innodb_buffer_pool_instances = 8
Un dettaglio importante: innodb_buffer_pool_instances ha effetto solo se innodb_buffer_pool_size è almeno 1 GB. Con 128 MB di default, il parametro viene ignorato. È un altro motivo per cui il problema era invisibile finché non si guardava la configurazione di base.
Su workload con alta concorrenza — e un e-commerce con picchi di traffico lo è — la differenza tra una e otto istanze può essere misurabile anche dopo aver risolto il problema principale del dimensionamento.
Leggere i segnali: hit ratio e pagine dirty #
Prima di toccare qualsiasi parametro, il punto di partenza è capire cosa sta succedendo. SHOW ENGINE INNODB STATUS è il comando che racconta la vita interna di InnoDB in un momento dato [4].
SHOW ENGINE INNODB STATUS\G
L’output è verboso. La sezione rilevante per il buffer pool è BUFFER POOL AND MEMORY:
----------------------
BUFFER POOL AND MEMORY
----------------------
Total large memory allocated 137363456
Dictionary memory allocated 409606
Buffer pool size   8192
Free buffers       1024
Database pages     7168
Old database pages 2624
Modified db pages  512
Pending reads      0
Pending writes: LRU 0, flush list 0, single page 0
Pages made young 1847392, not young 284719
0.00 youngs/s, 0.00 non-youngs/s
Pages read 9284719, created 48291, written 284719
0.00 reads/s, 0.00 creates/s, 0.00 writes/s
Buffer pool hit rate 501 / 1000, young-making rate 0 / 1000 not 0 / 1000
La riga chiave è Buffer pool hit rate. Nel formato X / 1000, un valore di 501 significa hit ratio del 50,1% — ogni due letture, una va su disco. L’obiettivo in produzione è stare sopra 990/1000, idealmente 995+.
Per un monitoraggio più granulare, le tabelle performance_schema e information_schema espongono metriche per istanza:
SELECT
  pool_id,
  pool_size,
  free_buffers,
  database_pages,
  hit_rate,
  pages_made_young,
  pages_not_made_young
FROM information_schema.INNODB_BUFFER_POOL_STATS;
Le Modified db pages (pagine dirty) meritano attenzione: un numero alto e stabile indica che il flush non riesce a stare al passo con le scritture. Se sale progressivamente, è un segnale che innodb_io_capacity va rivisto in relazione all’hardware disponibile.
Il restart e il problema del cold start #
C’è un aspetto del buffer pool che spesso viene ignorato fino al primo restart in produzione: dopo un riavvio, il pool è vuoto. Tutte le pagine calde che erano in memoria sono perse. Il sistema riparte freddo, e per un periodo variabile — da minuti a ore, a seconda del workload e della dimensione del pool — le performance sono degradate mentre InnoDB ricarica progressivamente i dati da disco.
MySQL offre un meccanismo per mitigare questo: il dump e il restore del buffer pool [5].
[mysqld]
# Salva il buffer pool allo shutdown
innodb_buffer_pool_dump_at_shutdown = ON

# Percentuale di pagine da salvare (default 25)
innodb_buffer_pool_dump_pct = 25

# Carica il buffer pool all'avvio
innodb_buffer_pool_load_at_startup = ON
Con innodb_buffer_pool_dump_at_shutdown = ON, MySQL salva in un file (per default ib_buffer_pool nella datadir) gli identificatori delle pagine che erano nel pool al momento dello shutdown. Al successivo avvio, con innodb_buffer_pool_load_at_startup = ON, le pagine vengono ricaricate in background.
Il file contiene solo gli identificatori (tablespace ID e page number), non i dati: il restore richiede che MySQL rilegga le pagine da disco, ma lo fa in modo organizzato e prioritario, riducendo significativamente il tempo di warm-up.
È possibile anche forzare il dump e il restore a runtime, senza aspettare uno shutdown:
-- Dump manuale del buffer pool
SET GLOBAL innodb_buffer_pool_dump_now = ON;

-- Restore manuale (utile dopo un restart non pianificato)
SET GLOBAL innodb_buffer_pool_load_now = ON;

-- Monitorare il progresso del restore
SHOW STATUS LIKE 'Innodb_buffer_pool_load_status';
Nel caso in esame, dopo aver configurato il dump automatico e aver fatto un restart controllato per applicare i nuovi parametri, il warm-up è durato circa 8 minuti invece delle 40-50 che ci si aspettava con un pool da 24 GB completamente freddo. Non è magia: è che il 25% delle pagine più calde copre la grande maggioranza degli accessi reali.
I numeri, prima e dopo #
Il confronto è netto:
| Metrica | Prima | Dopo |
|---|---|---|
innodb_buffer_pool_size | 128 MB | 24 GB |
innodb_buffer_pool_instances | 1 | 8 |
| Hit ratio | ~50% | ~997/1000 |
| Letture da disco | ~95% | <1% |
| Latenza media query | 45ms | 3ms |
| Throughput (query/s) | baseline | ~2× |
La latenza da 45ms a 3ms non è il risultato di una query riscritta o di un indice aggiunto. È il risultato di smettere di leggere da disco quello che poteva stare in RAM. Il disco era il collo di bottiglia, e il collo di bottiglia era lì dal giorno del provisioning.
Il throughput raddoppiato è una conseguenza diretta: meno attesa su I/O significa più query servite nello stesso tempo, con la stessa CPU.
Quello che resta da tenere a mente #
Il buffer pool non è l’unico parametro che conta in MySQL, ma è probabilmente quello con il rapporto impatto/complessità più alto. Un server con 32 GB di RAM e 128 MB di buffer pool è come un magazzino con 32 stanze che usa solo una per stoccare la merce: il resto del lavoro viene fatto comunque, ma con costi enormemente più alti.
Il punto non è che il default sia sbagliato in assoluto — 128 MB ha senso su una macchina condivisa con poca RAM o in un ambiente di sviluppo. Il punto è che il default non viene mai rivisto al momento del provisioning in produzione, e nessuno se ne accorge finché il sistema non inizia a soffrire.
La diagnosi parte sempre dall’hit ratio. Se è sotto 990/1000, il buffer pool è il primo posto dove guardare. Poi vengono le istanze, poi il warm-up, poi tutto il resto.
Il team ha anche impostato un alert sul hit ratio: sotto 985/1000 per più di cinque minuti, scatta una notifica. Non perché ci si aspetti di tornare al problema di prima, ma perché i sistemi cambiano — crescono i dati, cambiano i pattern di accesso, arriva un nuovo modulo — e conviene saperlo prima che la latenza torni a 45ms.
Fonti ufficiali #
- MySQL 8.0 Reference Manual — Making the Buffer Pool Scan Resistant
- MySQL 8.0 Reference Manual — Configuring InnoDB Buffer Pool Size
- MySQL 8.0 Reference Manual — Configuring Multiple Buffer Pool Instances
- MySQL 8.0 Reference Manual — SHOW ENGINE INNODB STATUS
- MySQL 8.0 Reference Manual — Saving and Restoring the Buffer Pool State
Glossario #
InnoDB buffer pool — Area di memoria principale di InnoDB dove vengono cachate pagine di dati e indici. Più è grande, meno letture finiscono su disco. Parametro:
innodb_buffer_pool_size.Hit ratio (buffer pool) — Percentuale di letture servite dalla memoria rispetto al totale. Si esprime in formato X/1000 nell’output di
SHOW ENGINE INNODB STATUS. Valori sotto 990/1000 indicano eccessiva dipendenza dal disco.Pagina dirty — Pagina del buffer pool modificata in memoria ma non ancora sincronizzata su disco. InnoDB le gestisce tramite flush in background; un numero elevato e crescente segnala che il flush non riesce a stare al passo con le scritture.
LRU list (InnoDB) — Struttura a due zone (young list + old list) usata da InnoDB per decidere quali pagine tenere in cache e quali rimuovere. Protegge le pagine calde dall’eviction causata da full scan occasionali.
Buffer pool warm-up — Processo di ricaricamento delle pagine calde nel buffer pool dopo un restart. Con
innodb_buffer_pool_dump_at_shutdowneinnodb_buffer_pool_load_at_startup, MySQL salva e ripristina gli identificatori delle pagine, riducendo il tempo di cold start da ore a minuti.