- Ivan Luminaria/
- Database Strategy/
- MySQL/
- Galera Cluster: quorum, split-brain e bootstrap di emergenza con due nodi giù/
Galera Cluster: quorum, split-brain e bootstrap di emergenza con due nodi giù
La telefonata delle 8 e 40 #
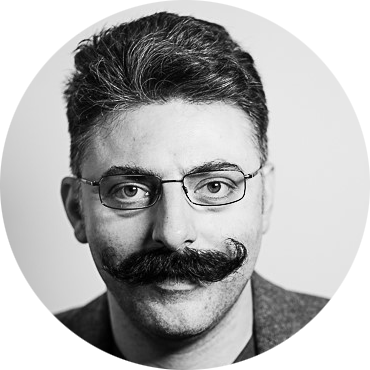
Era mattina presto. Stavo finendo il primo caffè quando è squillato il telefono: un collega in trasferta da un cliente, voce un po’ tesa. Mi racconta che il sistema di monitoraggio ha appena sparato due alert in sequenza su un cluster Galera a tre nodi. Mi legge il primo ticket:
Cluster Galera, uno dei nodi è fuori. Valore rilevato: 2. Nodo che ha generato l’alert:
mysql-node-01.
wsrep_cluster_size = 2. Un nodo fuori. Gli dico che non è un’emergenza immediata — il cluster è ancora operativo con due nodi su tre, il quorum regge. “Apri una console sul nodo che ha alertato e vediamo cosa è successo”, gli suggerisco. Ma mentre stava collegandosi via SSH, arriva il secondo ticket:
Cluster Galera, uno dei nodi è fuori. Valore rilevato: 2. Nodo che ha generato l’alert:
mysql-node-02.
Due ticket, quasi in sequenza. Il secondo arrivava da un nodo diverso, ma riportava ancora 2 come valore — il che significava che il cluster, dal punto di vista di mysql-node-02, aveva ancora due membri. “Ok, adesso la faccenda cambia”, gli dico. “Quale dei due era rimasto? Il nodo che ha sparato il primo alert era già fuori quando è arrivato il secondo, o no?”.
Questo articolo è il sequel naturale di quello sulla configurazione di un Galera Cluster a 3 nodi [articolo #33]. Quello spiega come si costruisce. Questo racconta cosa succede il giorno in cui i nodi cominciano a cadere uno dopo l’altro — e come si torna operativi, magari mentre stai guidando un collega al telefono che ha il cliente alle spalle.
Come il cluster conta i suoi membri (e perché quel numero è tutto) #
Prima di passargli i comandi da eseguire, gli ho chiesto trenta secondi per ricordargli il meccanismo che stava generando quegli alert — perché nel panico è facile guardare i numeri senza leggerli davvero.
Galera mantiene internamente il concetto di Primary Component (PC): il sottoinsieme di nodi che ha il quorum e può continuare a processare scritture. Quando un nodo esce, gli altri si accordano su chi fa parte del PC tramite il protocollo di membership. La variabile che espone questo stato è wsrep_cluster_size [1]:
SHOW GLOBAL STATUS LIKE 'wsrep_cluster_size';
SHOW GLOBAL STATUS LIKE 'wsrep_cluster_status';
SHOW GLOBAL STATUS LIKE 'wsrep_local_state_comment';
In un cluster sano a 3 nodi, wsrep_cluster_size vale 3 su tutti i nodi e wsrep_cluster_status riporta Primary. Quando un nodo esce, i due rimasti vedono wsrep_cluster_size = 2 — ma continuano a operare perché hanno ancora il quorum (2 su 3 > 50%).
Il problema diventa critico quando escono due nodi su tre. Il nodo rimasto non ha il quorum: non può sapere se è lui ad essere isolato o se sono gli altri due ad avere problemi. Per evitare lo split-brain — due partizioni che accettano entrambe scritture divergenti — Galera applica una regola semplice: senza quorum, nessuna scrittura. Il nodo sopravvissuto passa in stato non-Primary e smette di accettare DML.
Il monitoraggio del cliente era configurato per alertare su wsrep_cluster_size < 3. Corretto. Ma i due alert quasi simultanei suggerivano uno scenario più complesso di un semplice nodo riavviato — e volevo che il collega ci arrivasse prima di digitare qualsiasi comando invasivo.
Diagnosi: capire cosa era successo davvero #
“La prima cosa che facciamo è costruire una mappa temporale”, gli dico. “Chi è uscito per primo? In che stato sono i nodi adesso? Vai sul terzo nodo, quello che non ha sparato nessun alert.”
Sul terzo nodo (mysql-node-03, quello silenzioso) gli faccio lanciare:
SHOW GLOBAL STATUS LIKE 'wsrep%';
Mi legge l’output rilevante:
wsrep_cluster_size          | 1
wsrep_cluster_status        | non-Primary
wsrep_local_state_comment   | Initialized
wsrep_connected             | ON
wsrep_ready                 | OFF
“Ok, brutta storia”, commento. wsrep_cluster_size = 1 e wsrep_cluster_status = non-Primary. Il nodo era ancora in piedi, connesso alla rete, ma non accettava scritture. Aveva perso il quorum.
Gli chiedo di provare a collegarsi agli altri due. Su mysql-node-01 e mysql-node-02 MySQL non risponde — entrambi giù. Gli faccio aprire l’error log di mysql-node-01 e mi legge:
[ERROR] WSREP: gcs/src/gcs_group.cpp:gcs_group_handle_join_msg():736:
  Member 1 (mysql-node-02) requested state transfer from '*any*'.
[Warning] WSREP: Member 1 (mysql-node-02) is waiting for SST from donor.
[ERROR] WSREP: Process completed with error: wsrep_sst_xtrabackup-v2 ...
[ERROR] WSREP: SST failed: 32 (Broken pipe)
“Ecco la sequenza”, gli spiego. mysql-node-01 era uscito per primo (probabilmente per un problema di rete o OOM), mysql-node-02 aveva tentato di rientrare nel cluster tramite SST (State Snapshot Transfer), l’SST era fallita, e nel frattempo anche mysql-node-02 era caduto. Il nodo rimasto, mysql-node-03, si era ritrovato solo e aveva perso il quorum.
Le cause più comuni che vale la pena escludere #
“Prima di procedere al recovery, capiamo perché un nodo esce”, gli dico. Non serve per il fix immediato, ma per non ritrovarci nella stessa situazione tra due ore. Le cause più frequenti in produzione:
- Problemi di rete: latenza alta o packet loss tra i nodi. Galera usa
evs.suspect_timeouteevs.inactive_timeoutper decidere quando espellere un nodo. Un nodo lento a rispondere viene espulso anche se MySQL è sano. - OOM killer: il kernel Linux termina
mysqldper pressione di memoria. Si vede indmesgo/var/log/messages. - Slow applier: il nodo non riesce a stare dietro al flusso di writeset.
wsrep_local_recv_queue_avgalto è un segnale. - gcache overflow: se il nodo è stato offline abbastanza a lungo da non trovare i writeset necessari nel gcache degli altri nodi, non può fare IST e deve fare SST — che è molto più pesante.
Gli faccio guardare dmesg su mysql-node-01. Ci mette dieci secondi: Out of memory: Kill process [mysqld] circa 20 minuti prima del primo alert. OOM killer, candidato principale. Me lo segno mentalmente per dopo — prima recuperiamo il cluster.
SST e IST: non è la stessa cosa rientrare nel cluster #
“Adesso ti spiego perché l’SST è fallita, così capisci cosa dobbiamo evitare quando faremo rientrare i nodi”, gli dico.
Quando un nodo rientra dopo un’assenza, Galera deve sincronizzarlo con lo stato corrente del cluster. Ci sono due modalità [2]:
IST (Incremental State Transfer): il nodo riceve solo i writeset che si è perso, dal gcache degli altri nodi. È veloce, non interrompe il donor, non richiede un full backup. Funziona solo se il gap è piccolo e i writeset necessari sono ancora nel gcache.
SST (State Snapshot Transfer): trasferimento completo dello stato — essenzialmente un backup fisico (con xtrabackup, mysqldump, o rsync) dal donor al joiner. È lento, può mettere sotto pressione il donor, e durante l’SST il donor può diventare non-responsive per le letture (dipende dal metodo). È necessario quando il gap è troppo grande per IST.
La distinzione pratica: se un nodo è stato offline per pochi minuti e il gcache è dimensionato correttamente (wsrep_provider_options = "gcache.size=2G" come punto di partenza), IST è quasi garantita. Se il nodo è stato offline per ore o giorni, SST è inevitabile.
“Nel vostro caso”, gli dico, “l’SST fallita è il punto critico”. mysql-node-02 aveva tentato di rientrare, il donor aveva iniziato il trasferimento, ma qualcosa aveva interrotto il processo (il Broken pipe nel log suggeriva un problema di connessione durante il trasferimento). E nel frattempo mysql-node-02 era rimasto in uno stato inconsistente — né dentro né fuori.
La procedura di recovery: ordine e pazienza #
“Ok, adesso ricomponiamo. Con due nodi giù e uno in non-Primary, l’ordine conta più di tutto il resto. Non partire con niente prima che te lo dica.”
Passo 1: identificare il nodo più aggiornato #
Prima di far rientrare qualsiasi nodo, bisogna capire quale ha la sequenza di transazioni più avanzata. Questo è il nodo che diventerà il donor per gli altri.
“Vai su ogni nodo, anche quelli con MySQL giù, e leggimi il file di stato di Galera”:
cat /var/lib/mysql/grastate.dat
Output tipico:
# GALERA saved state
version: 2.1
uuid:    6b3f8c2a-1234-11ee-abcd-0242ac110003
seqno:   847392
safe_to_bootstrap: 0
Il nodo con seqno più alto è quello più aggiornato. Se safe_to_bootstrap: 1, Galera stesso ha già identificato quel nodo come sicuro per il bootstrap. Se tutti i nodi mostrano safe_to_bootstrap: 0 (scenario comune dopo un crash simultaneo), bisogna scegliere manualmente il nodo con seqno più alto e modificare il file.
Passo 2: bootstrap del nodo più aggiornato #
“Adesso arriva il pezzo delicato, quindi seguimi passo passo e non correre.” Il bootstrap di emergenza è il momento più delicato: si tratta di avviare il primo nodo come nuovo Primary Component, senza aspettare gli altri.
# Sul nodo con seqno più alto, modificare grastate.dat
# Impostare safe_to_bootstrap: 1

# Poi avviare con --wsrep-new-cluster
galera_new_cluster
# oppure, a seconda della distribuzione:
mysqld_safe --wsrep-new-cluster &
Questo crea un nuovo cluster con un solo membro. Il nodo diventa Primary e inizia ad accettare scritture. Attenzione: se si fa bootstrap sul nodo sbagliato (quello con seqno più basso), si perdono le transazioni che erano già state committate sul nodo più avanzato. “Prenditi due minuti in più e verifica i seqno di tutti e tre i nodi prima di scegliere. Meglio due minuti adesso che una rollback complicata dopo.”
Mi rilegge i valori: mysql-node-03 (l’unico rimasto in piedi) aveva seqno: 847392, mentre mysql-node-01 mostrava seqno: 847389. “Bene, il bootstrap va fatto su mysql-node-03.”
Passo 3: far rientrare i nodi uno alla volta #
“Aspetta che il primo nodo sia Primary, poi partiamo con il secondo. Uno alla volta, mi raccomando.” Si avviano normalmente (senza --wsrep-new-cluster) e Galera gestisce la sincronizzazione:
systemctl start mysql
Il nodo che rientra si connette al cluster, negozia IST o SST, e si sincronizza. Durante questa fase, gli faccio tenere aperto un ciclo di controllo su:
SHOW GLOBAL STATUS LIKE 'wsrep_local_state_comment';
-- Progressione attesa: Joining -> Waiting for SST -> Joined -> Synced
“Aspetta Synced prima di toccare il terzo nodo. Se li avvii tutti insieme aumenti il carico sul donor e rischiamo un’altra SST fallita — e a quel punto ricominciamo daccapo.”
Passo per passo, con il collega al telefono #
A questo punto la telefonata è diventata operativa. Gli dettavo i comandi, lui li eseguiva e mi rileggeva l’output. È andata così:
- Verificato
grastate.datsu tutti e tre i nodi.mysql-node-03aveva il seqno più alto ed era già in piedi (in statonon-Primary). - Riavviato
mysql-node-03congalera_new_clusterdopo aver impostatosafe_to_bootstrap: 1nel suograstate.dat. Il nodo è passato subito aPrimaryconwsrep_cluster_size = 1. “Bene, respiriamo un momento.” - Avviato
mysql-node-01. Ha negoziato IST (il gap era di poche migliaia di writeset, il gcache era sufficiente). Sincronizzato in circa 3 minuti. Il collega mi leggeSyncede sento che si rilassa un po'. - Avviato
mysql-node-02. Anche qui IST, sincronizzato in 4 minuti. - Verificato su tutti e tre i nodi:
wsrep_cluster_size = 3,wsrep_cluster_status = Primary,wsrep_local_state_comment = Synced.
Il cluster era tornato operativo. Il downtime effettivo per le scritture era stato di circa 35 minuti — il tempo tra la caduta del secondo nodo e il completamento del bootstrap. Il collega chiude la chiamata con un “grazie, ora vado a spiegare al cliente cosa è successo”. Il grosso del merito, gli dico prima di riattaccare, è che ha tenuto la testa fredda e non ha toccato niente prima di capire.
Quello che resta da fare dopo il recovery #
Il recovery è la parte visibile. La parte che conta di più è quello che si fa dopo, quando la pressione è scesa. Nel pomeriggio ho fatto un secondo giro di chiamata con il collega per mettere nero su bianco quello che valeva la pena sistemare.
Sul monitoraggio: l’alert su wsrep_cluster_size < 3 era corretto, ma mancava un alert su wsrep_cluster_status != Primary. Sono due condizioni diverse: un cluster può avere cluster_size = 2 e essere ancora Primary (un nodo è uscito ma il quorum regge), oppure avere cluster_size = 1 e essere non-Primary (nessuna scrittura possibile). Il secondo scenario richiede intervento immediato, il primo ha più margine.
Sul gcache: dimensionare il gcache in modo che IST sia possibile per le assenze brevi. Un gcache da 512MB in un cluster con alto throughput di scrittura si esaurisce in pochi minuti. Aumentarlo a 2-4GB riduce drasticamente la necessità di SST per riavvii rapidi.
Sull’OOM: il problema originale era l’OOM killer su mysql-node-01. La soluzione non era nel cluster Galera — era nella configurazione della memoria di MySQL (innodb_buffer_pool_size troppo aggressivo per la RAM disponibile) e nell’assenza di swap. Due cose che non hanno nulla a che fare con la replica, ma che in un cluster HA diventano critiche perché il crash di un processo si propaga come evento di membership.
Sul bootstrap: documentare la procedura di bootstrap di emergenza nel runbook operativo, con i comandi esatti e l’ordine corretto. È una procedura che si fa raramente, sotto pressione, con il cliente che chiede aggiornamenti ogni cinque minuti. Non è il momento di ricordarsela a memoria — o di dover chiamare un collega perché non te la ricordi.
Il runbook che avremmo voluto avere quella mattina #
Questa è la versione sintetica della procedura, da tenere a portata di mano — quella che il collega si è salvato in un file nel repo del cliente prima di chiudere la giornata:
# 1. Verificare stato su tutti i nodi
mysql -e "SHOW GLOBAL STATUS LIKE 'wsrep%';" 2>/dev/null || echo "MySQL down"

# 2. Leggere seqno da grastate.dat (anche se MySQL è giù)
cat /var/lib/mysql/grastate.dat

# 3. Sul nodo con seqno più alto: abilitare bootstrap
sed -i 's/safe_to_bootstrap: 0/safe_to_bootstrap: 1/' /var/lib/mysql/grastate.dat

# 4. Bootstrap del primo nodo
galera_new_cluster

# 5. Verificare che sia Primary
mysql -e "SHOW GLOBAL STATUS LIKE 'wsrep_cluster_status';"

# 6. Avviare gli altri nodi uno alla volta
systemctl start mysql
# Aspettare Synced prima del prossimo

# 7. Verifica finale su tutti i nodi
mysql -e "SHOW GLOBAL STATUS LIKE 'wsrep_cluster_size'; SHOW GLOBAL STATUS LIKE 'wsrep_cluster_status';"
Semplice sulla carta. Meno semplice quando sei da un cliente, hai il secondo ticket sul monitor e stai aspettando che qualcuno all’altro capo del telefono ti dica da dove partire.
Fonti ufficiali #
- Codership — Galera Cluster Documentation: wsrep Status Variables <TODO: scout URL specifico per wsrep_cluster_size>
- Percona Documentation — State Snapshot Transfer (SST) and Incremental State Transfer (IST)
- Codership — Galera Cluster Recovery <TODO: scout URL specifico per bootstrap di emergenza>
- Percona Blog — gcache sizing <TODO: scout URL aggiornato>
Glossario #
Primary Component (PC) (Galera) — Il sottoinsieme di nodi che detiene il quorum e può continuare a processare scritture. Un nodo fuori dal PC passa in stato
non-Primarye smette di accettare DML per evitare split-brain.wsrep_cluster_size (Galera) — Variabile di stato che riporta il numero di nodi attualmente nel cluster Galera. Valore atteso in un cluster a 3 nodi:
3. Scendere sotto la soglia di quorum (≤ 1 su 3) blocca le scritture.IST (Incremental State Transfer) (Galera) — Sincronizzazione incrementale di un nodo che rientra nel cluster: riceve solo i writeset mancanti dal gcache degli altri nodi. Veloce e non invasivo per il donor; possibile solo se il gap è coperto dal gcache.
SST (State Snapshot Transfer) (Galera) — Trasferimento completo dello stato da un nodo donor a un joiner: equivale a un backup fisico completo. Necessario quando il gap è troppo grande per IST. Può rallentare il donor durante il trasferimento.
gcache (Galera) — Buffer circolare su disco che ogni nodo Galera mantiene per conservare i writeset recenti. Dimensionare il gcache correttamente (
gcache.size) è la principale leva per favorire IST rispetto a SST nei riavvii brevi.