Il restart ha risolto. Il problema è ancora lì.
Un incident che si chiude senza causa ricostruita non è un episodio isolato. Come leggere AWR, ASH e change log a freddo prima che arrivi il secondo guasto.
Datadog e Dynatrace mostrano sintomi, non cause. Come spiegare al board perché l'observability moderna non basta senza un lettore competente.
Un incident che si chiude senza causa ricostruita non è un episodio isolato. Come leggere AWR, ASH e change log a freddo prima che arrivi il secondo guasto.
Aggiungere CPU, RAM o IOPS a un database lento spesso non risolve il problema. Come distinguere la causa reale dal sintomo prima di firmare il preventivo.
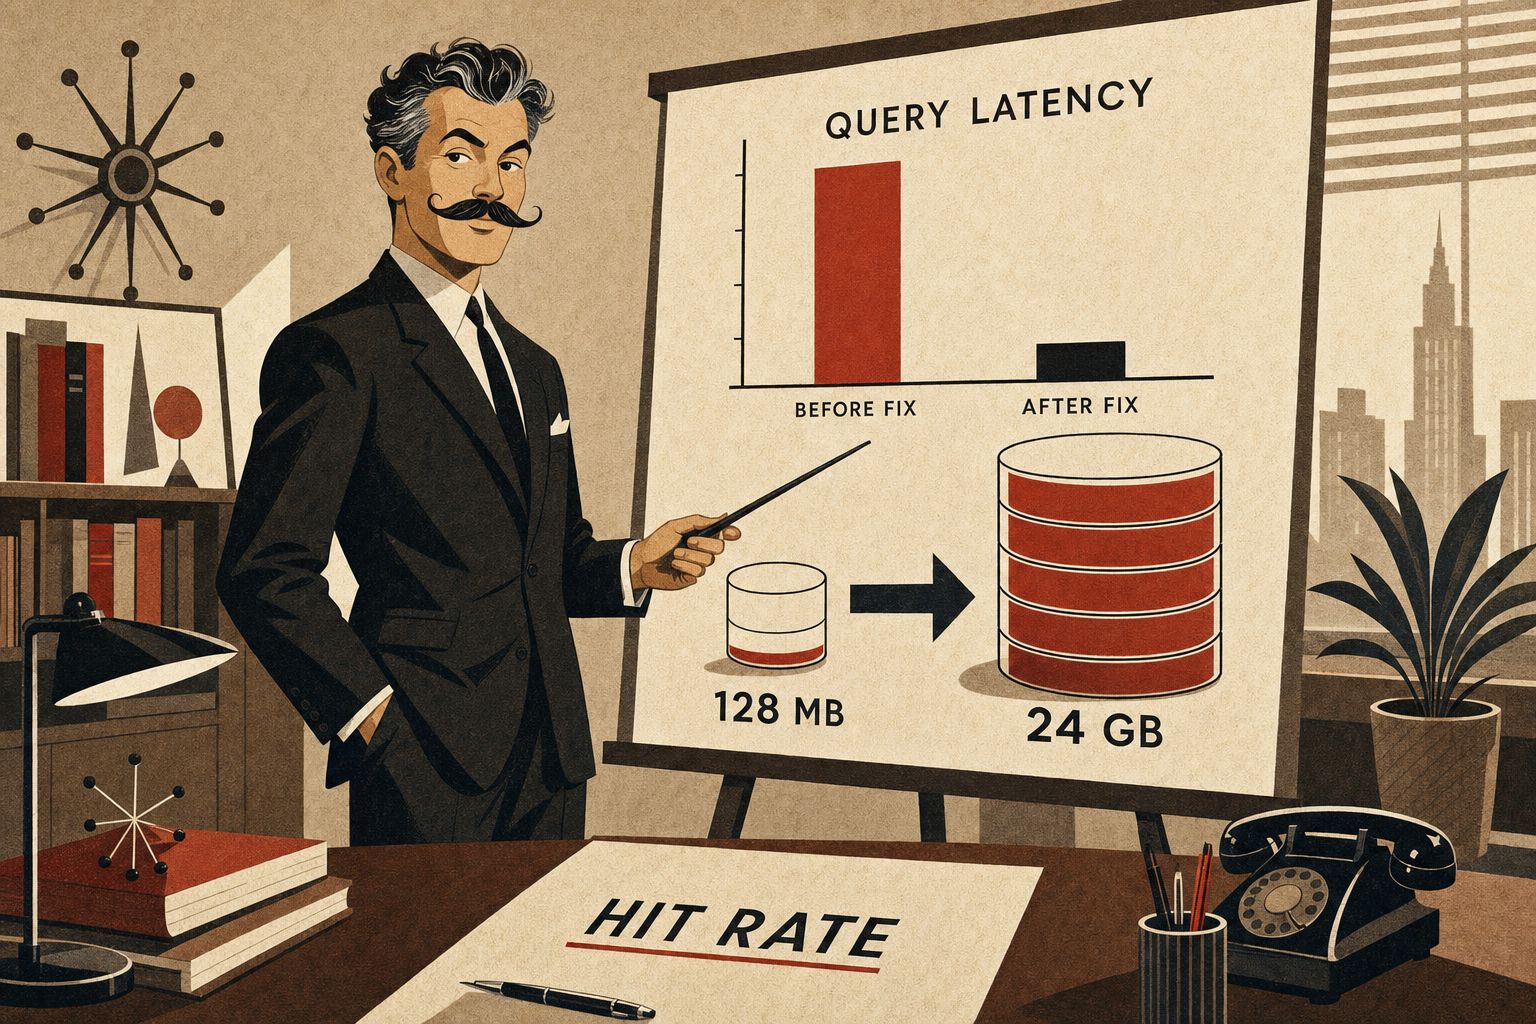
128 MB di default su 32 GB di RAM: diagnosi, dimensionamento, buffer pool instances e warm-up dopo restart. Numeri reali prima e dopo il fix.
Come un bambino curioso, un programma in BASIC e una porta chiusa a chiave hanno tracciato la strada verso il mestiere di diagnosticare sistemi complessi.
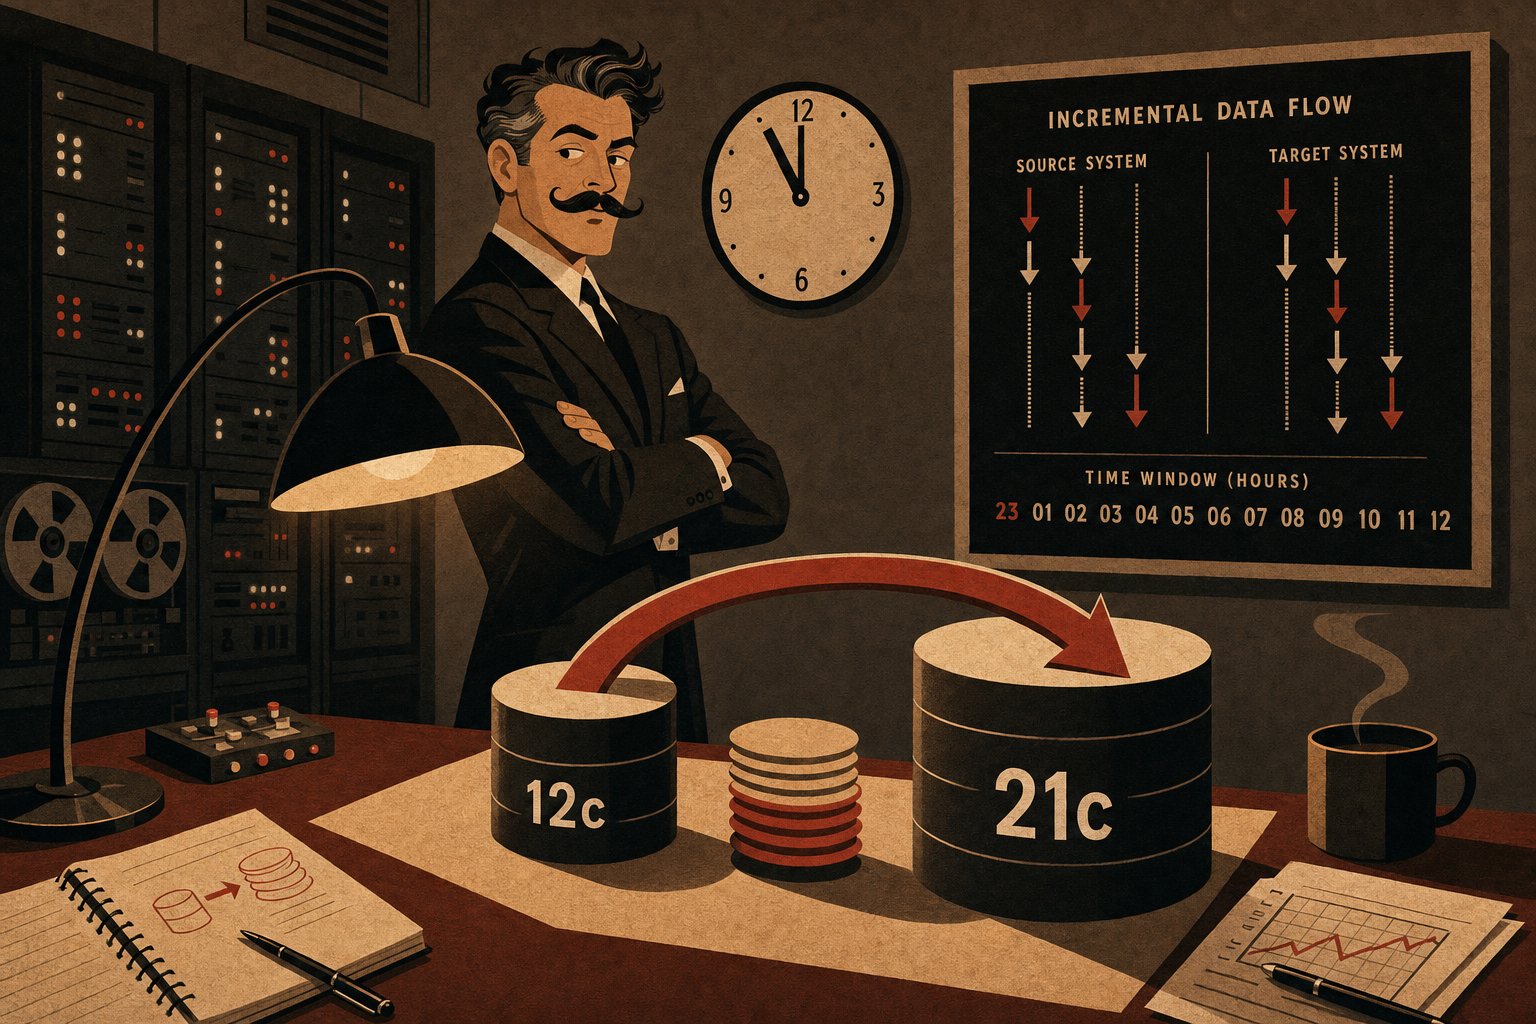
Strategia ibrida con transportable tablespaces e RMAN incremental per migrare 12 TB da Oracle 12c a 21c. Piano passo per passo, tempi reali, problemi nascosti.
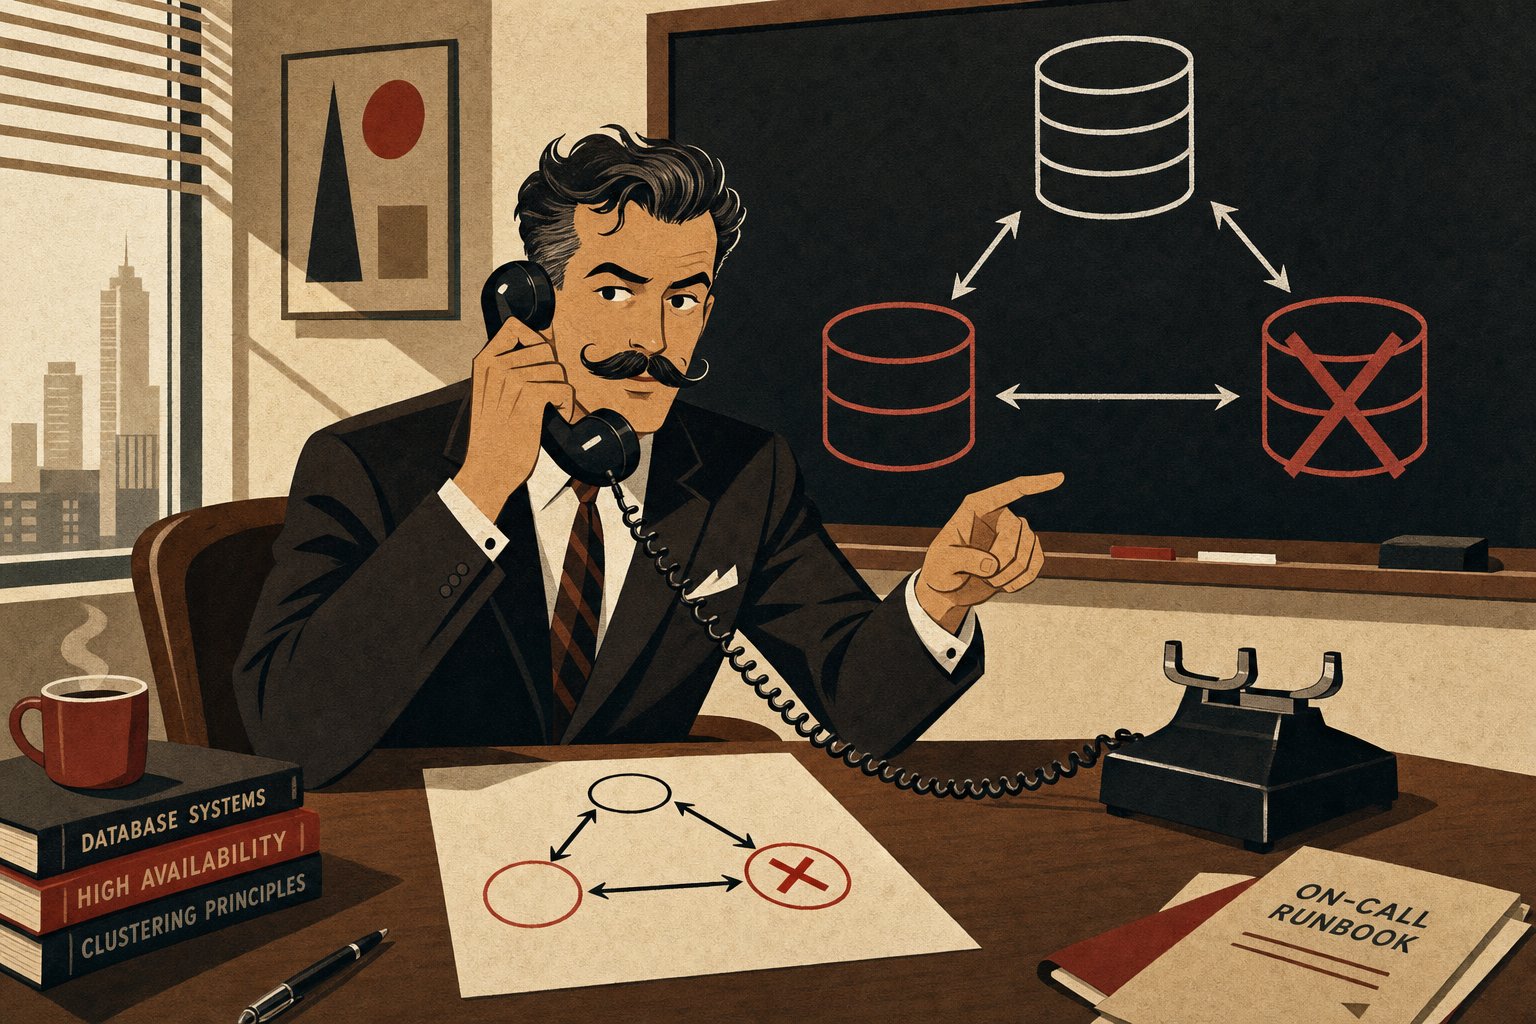
Due ticket di monitoraggio, due nodi fuori dal cluster Galera in sequenza. Diagnosi passo per passo: wsrep_cluster_size, quorum, SST/IST, bootstrap di emergenza.
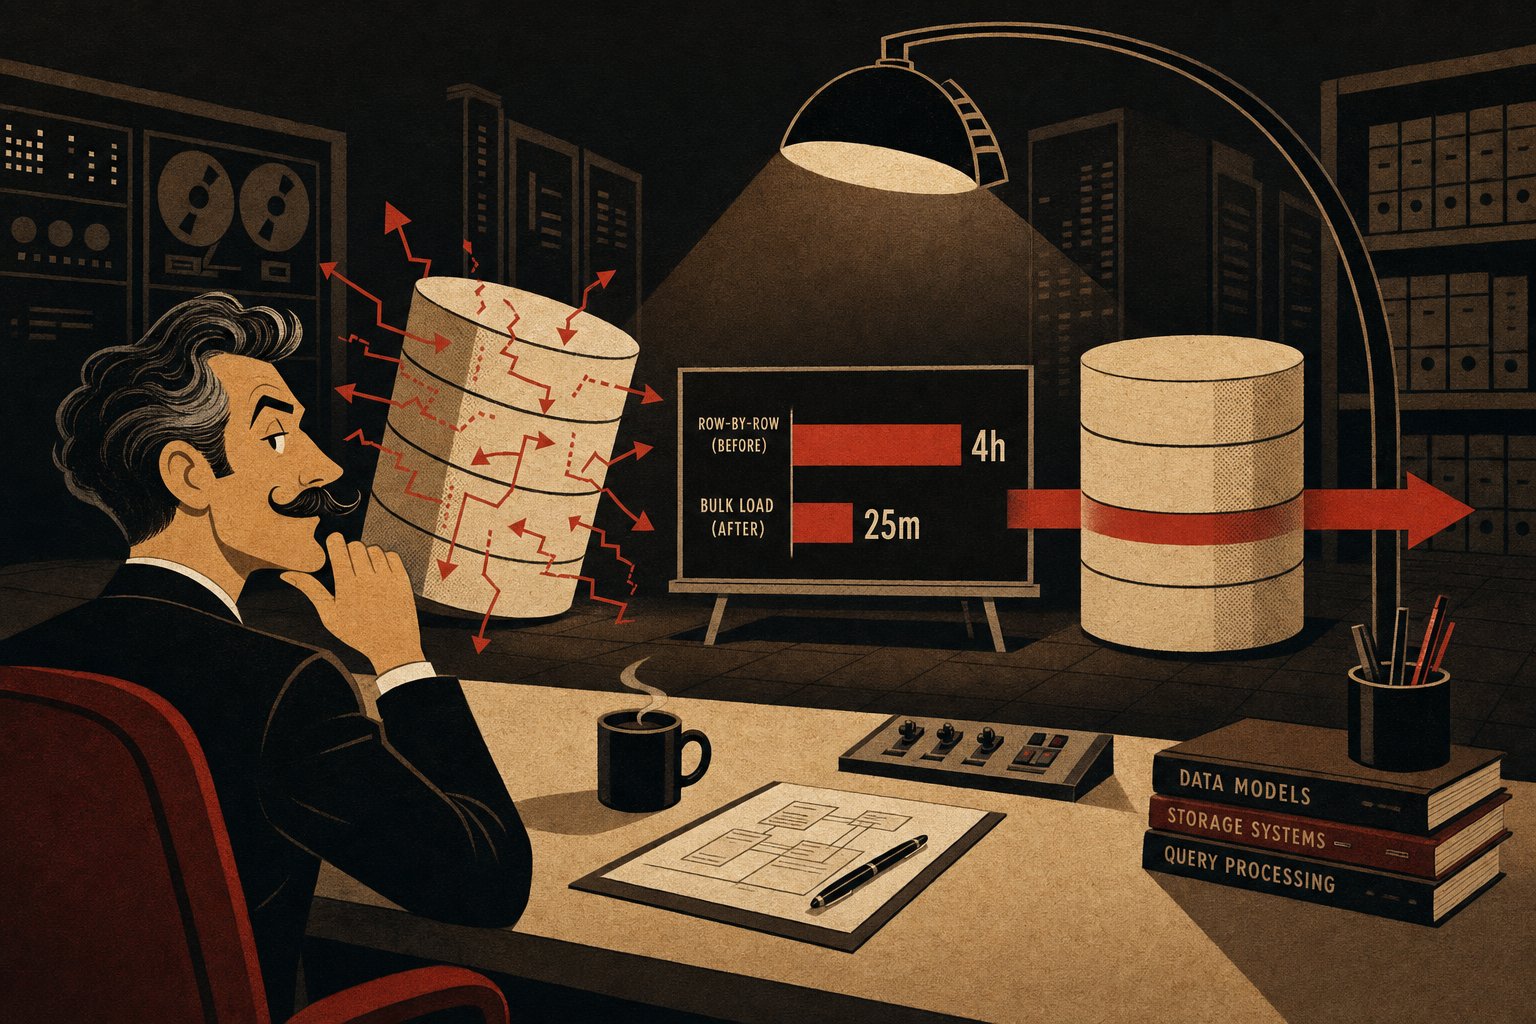
Un ETL notturno su DWH Oracle: 15 milioni di righe, finestra batch in esaurimento. Diagnosi, riscrittura con staging tables, MERGE e parallel DML. Numeri prima e dopo.
Da una pausa pranzo con un senior data analyst assicurativo emergono i gap di governance prima del go-live: data quality, lineage, ownership, GDPR e Transparent Data Encryption su Oracle 19c.
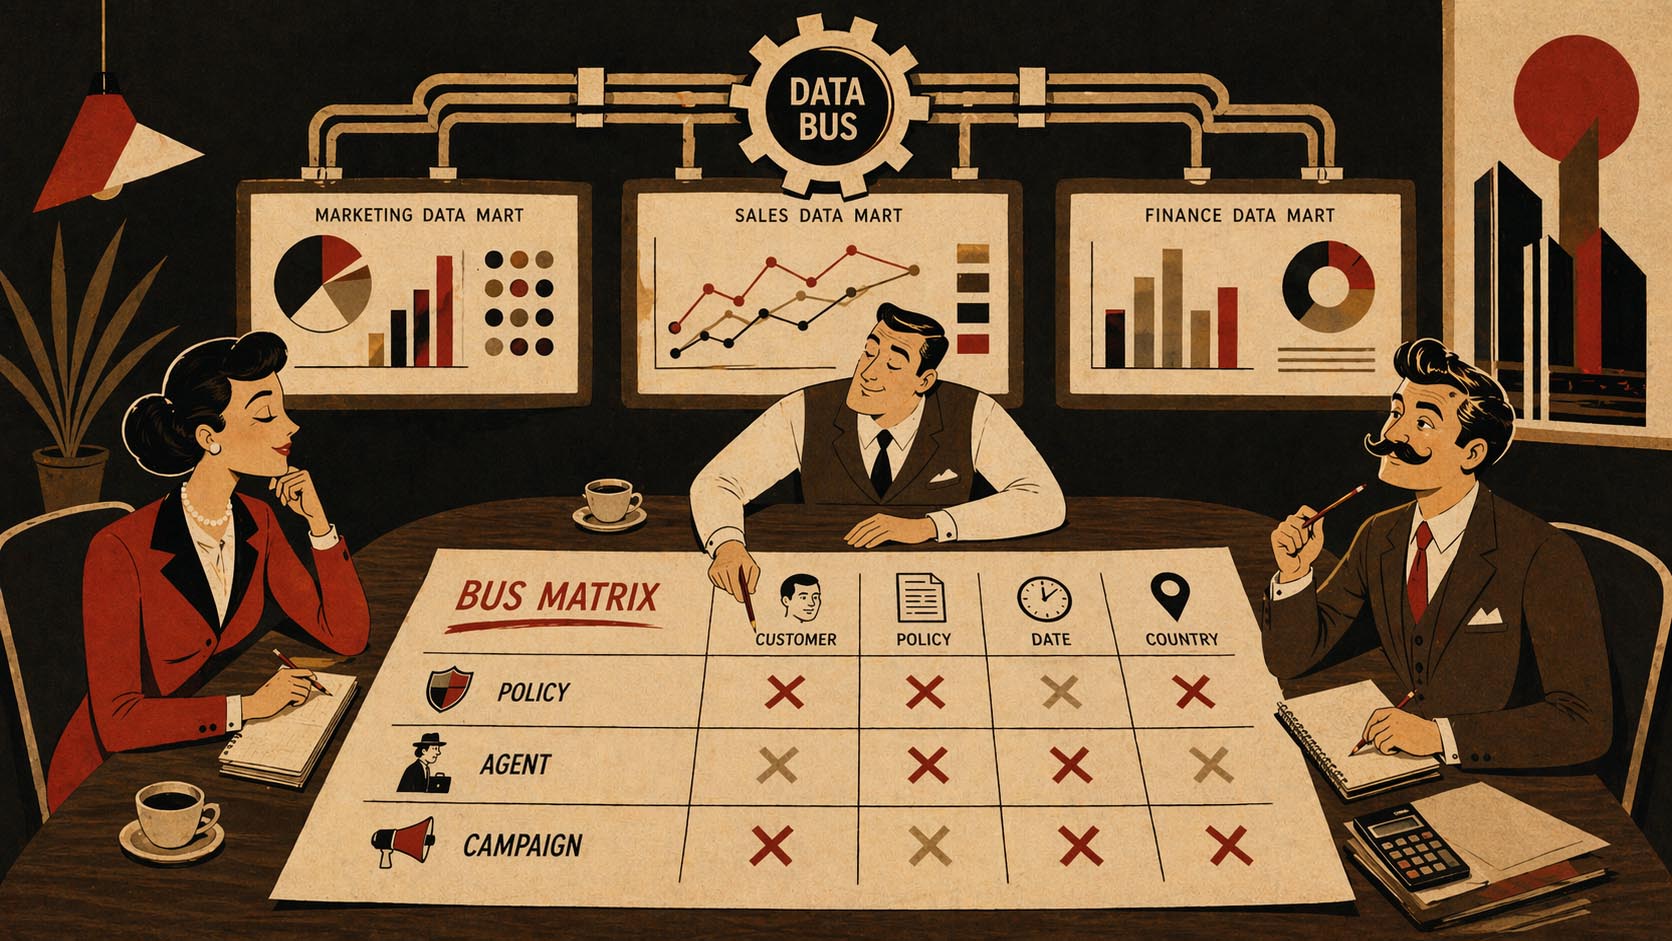
Bus matrix di Kimball per allineare data mart isolati: dimensioni conformi, processi di business e vendite confrontabili. Caso reale gruppo assicurativo.
Range partitioning su fact table da 800 milioni di righe: da query trimestrali di 12 minuti a 40 secondi. Implementazione mensile, exchange e indici locali.
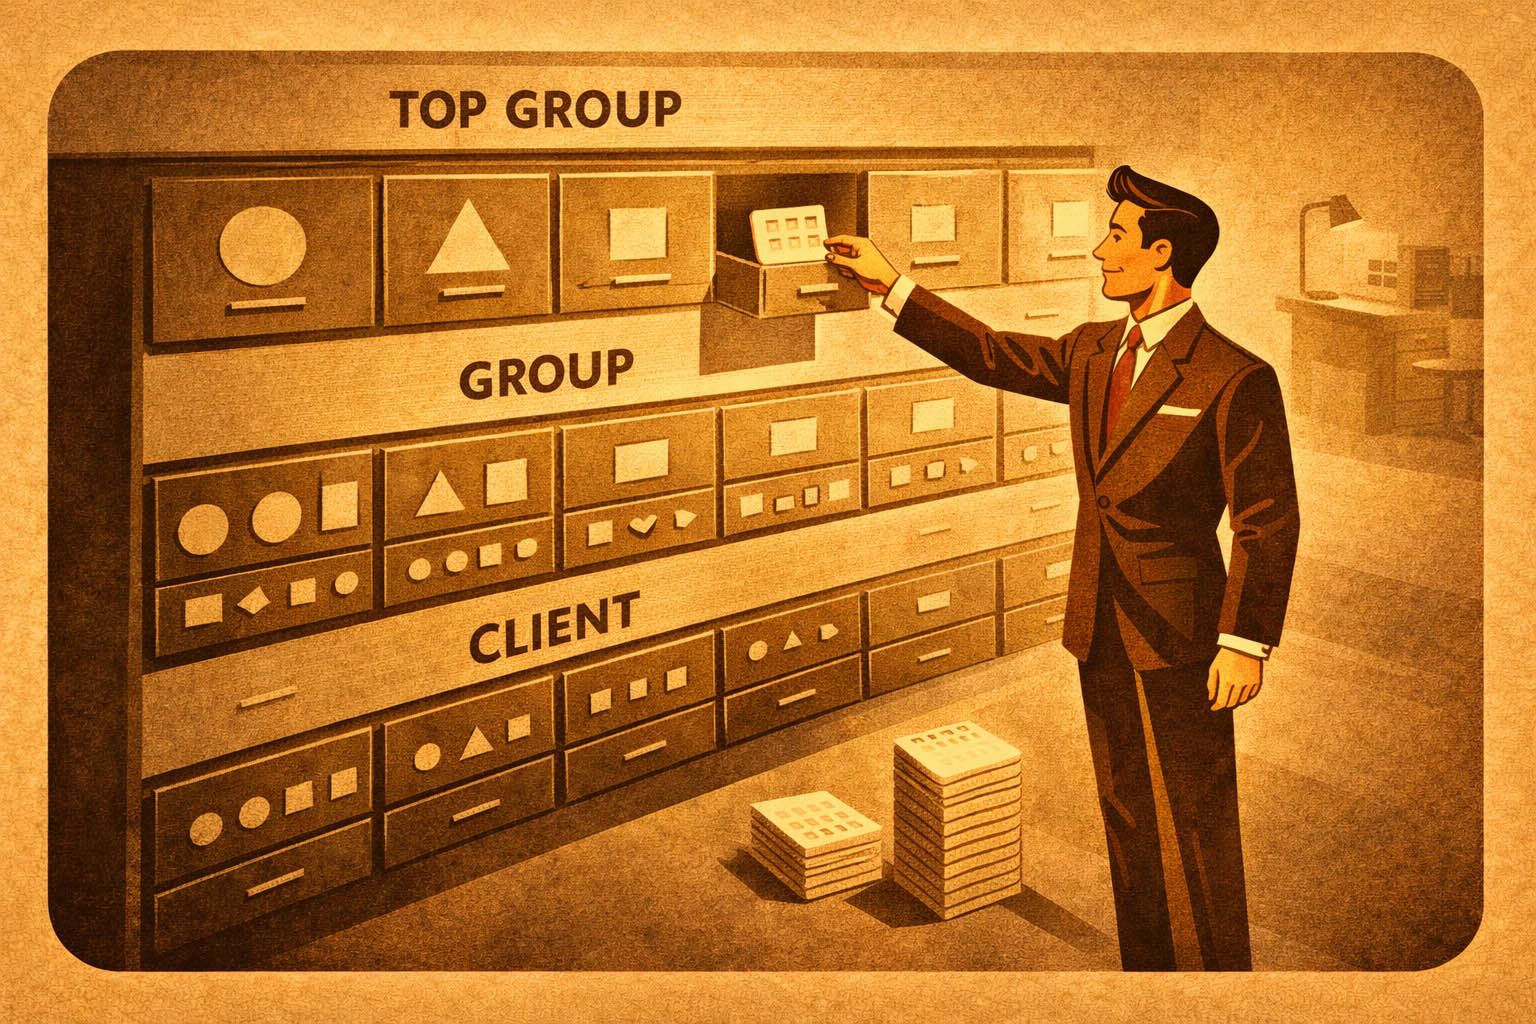
Ragged hierarchy nel data warehouse: bilanciamento di gerarchie sbilanciate con la tecnica del self-parenting. Drill-down corretto su clienti e gruppi.
SCD Tipo 2 nel data warehouse: storicizzare dimensioni con chiavi surrogate e date di validità. Caso reale: dimensione clienti che evolve nel tempo.
Data warehouse: la grana della fact table determina quali domande puoi rispondere. Errori frequenti nella granularità e impatto sul modello dimensionale.
Datadog e Dynatrace mostrano sintomi, non cause. Come spiegare al board perché l'observability moderna non basta senza un lettore competente.
Un incident che si chiude senza causa ricostruita non è un episodio isolato. Come leggere AWR, ASH e change log a freddo prima che arrivi il secondo guasto.
Aggiungere CPU, RAM o IOPS a un database lento spesso non risolve il problema. Come distinguere la causa reale dal sintomo prima di firmare il preventivo.
Come un bambino curioso, un programma in BASIC e una porta chiusa a chiave hanno tracciato la strada verso il mestiere di diagnosticare sistemi complessi.
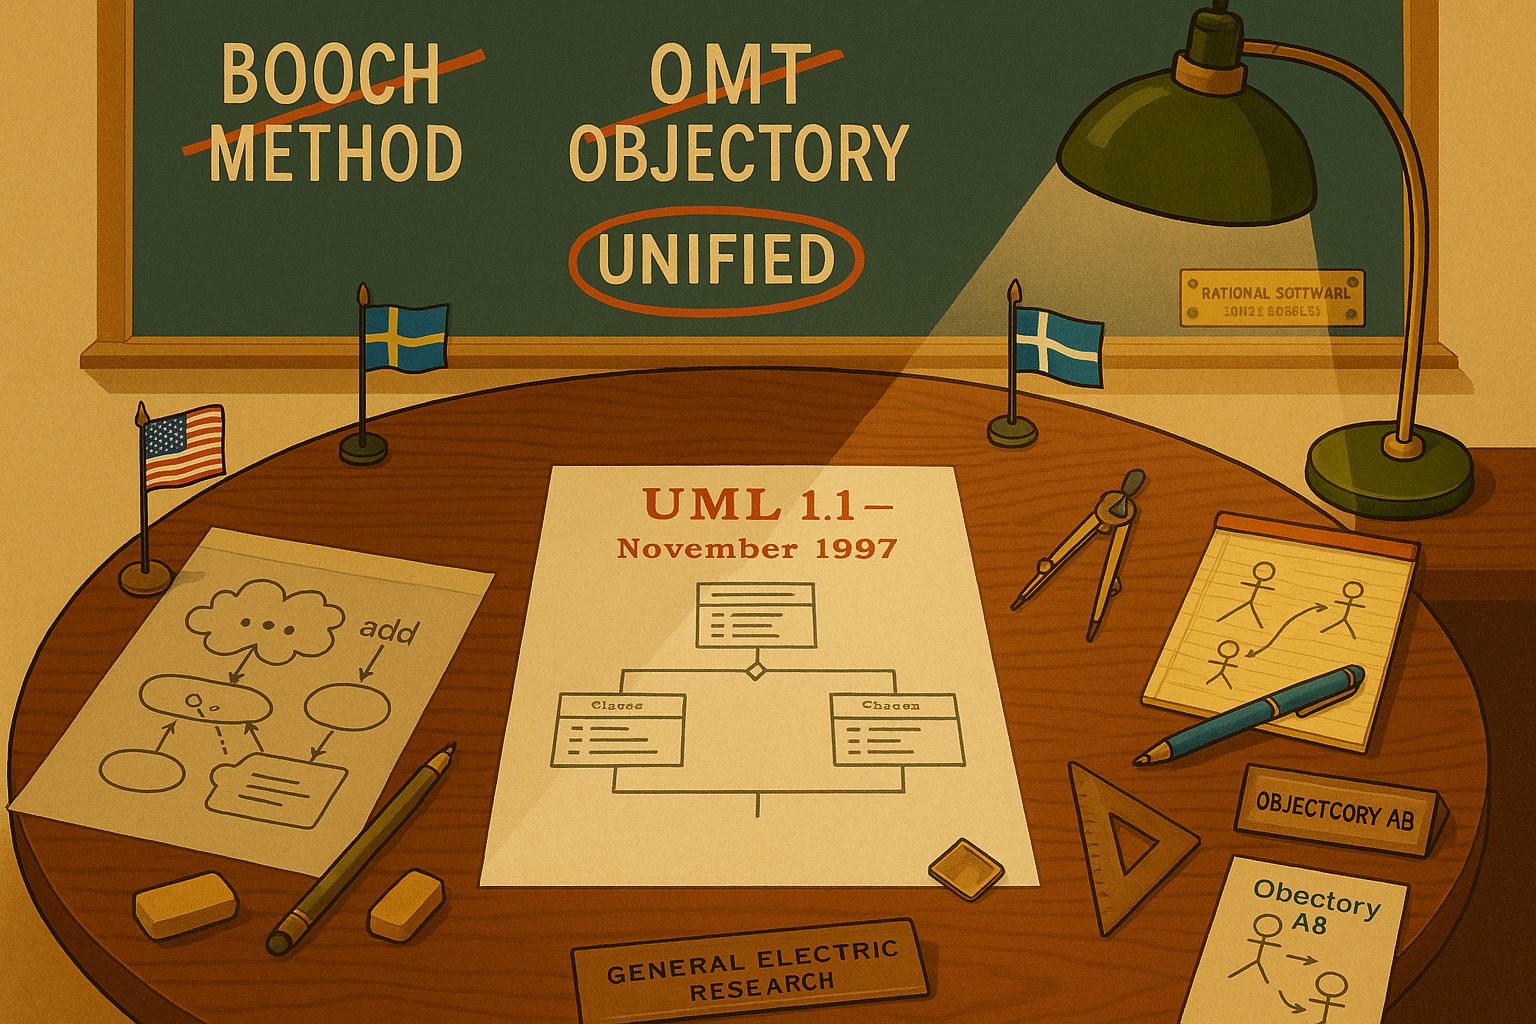
La storia dei Three Amigos di UML e RUP: come Booch, Rumbaugh e Jacobson, da rivali, hanno unificato l'object-oriented modeling. E cosa ne resta oggi.
Project management: 5 regole osservate nei team che reggono sotto pressione. Psychological safety, bus factor, outcome vs output, knowledge transfer.
AI Manager: il ruolo che governa l'impatto dell'intelligenza artificiale su architetture, processi e persone. Riflessioni da 30 anni di IT.
Strategia ibrida con transportable tablespaces e RMAN incremental per migrare 12 TB da Oracle 12c a 21c. Piano passo per passo, tempi reali, problemi nascosti.
Come Oracle Text risolve ricerche lente su archivi di documenti ed email: indici CONTEXT, CATSEARCH e CTXXPATH configurati sulle reali esigenze di ricerca.
Oracle 26ai introduce CREATE ASSERTION, il vincolo cross-tabella promesso da SQL-92. Sintassi, confronto con i trigger e un caso reale assicurativo.
Diagnosi guidata di ORA-00205 in piena emergenza notturna: fase MOUNT, control file, SPFILE, redo log. Metodo pratico per i DBA Oracle reperibili.
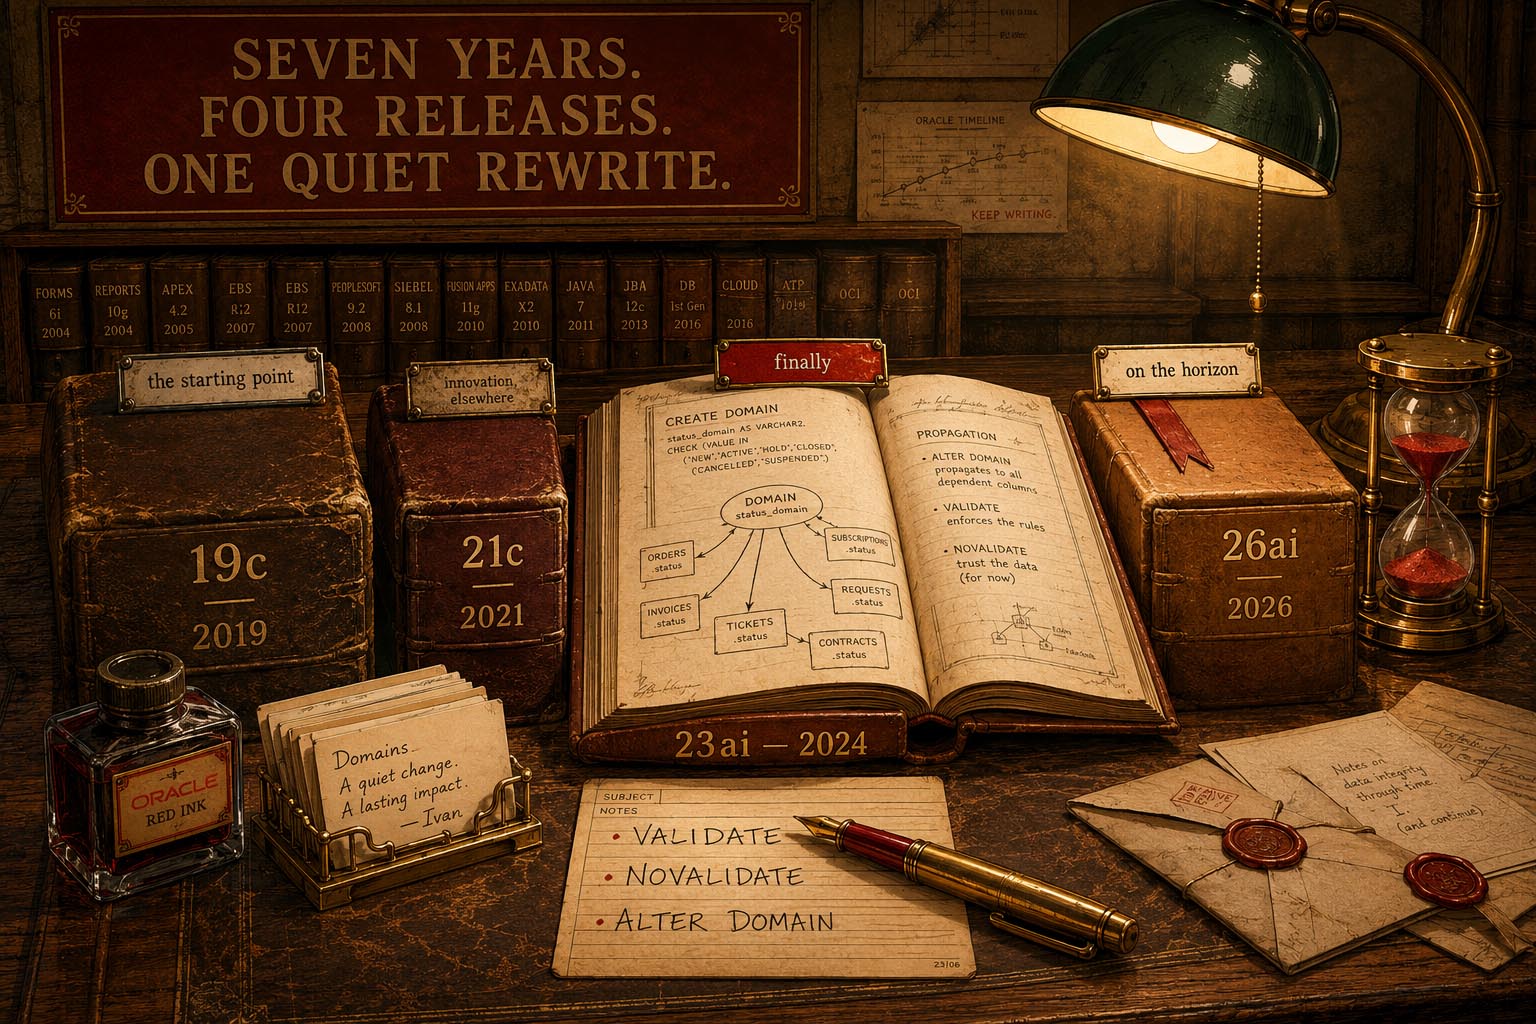
Sette anni di Oracle visti attraverso le enumerazioni: dal CHECK del 19c ai SQL Domains della 23ai, fino alle Assertion del 26ai. Una migrazione assicurativa.
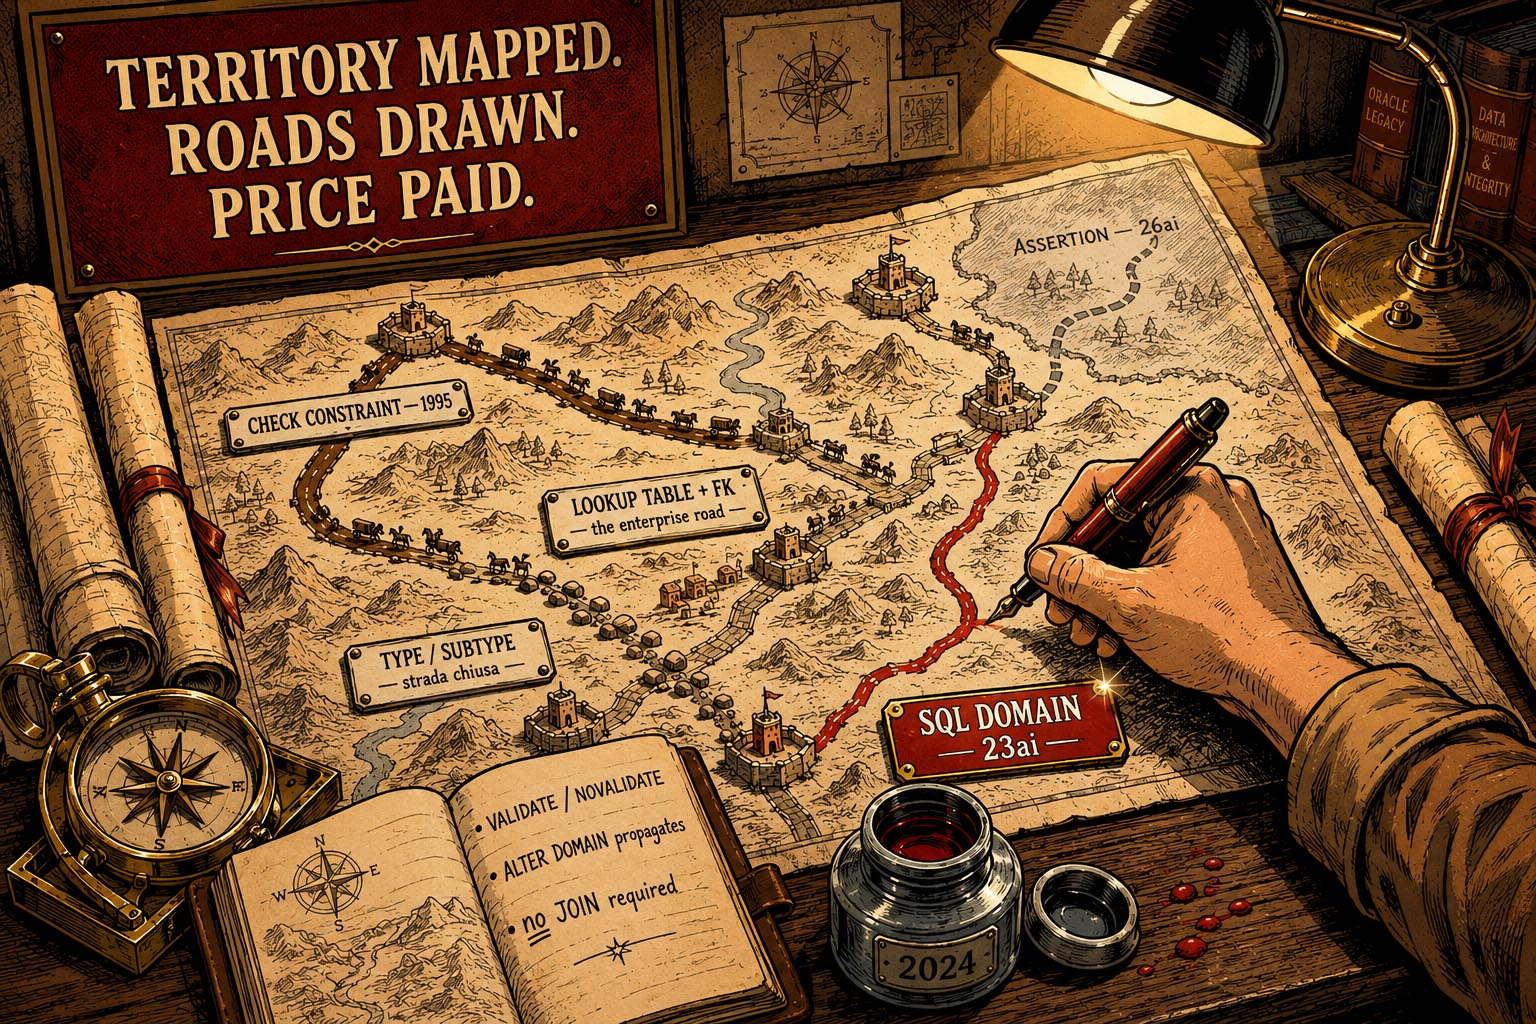
Oracle non ha mai avuto ENUM nativo. CHECK constraint, lookup table e SQL Domains 23ai: tre strade, un caso reale banking, e cosa arriverà con la 26ai.
Migrazione Oracle 19c on-premises a OCI: 2 TB con RAC e Data Guard. BYOL licensing, Data Pump, cutover notturno — cronaca reale.
Replica logica PostgreSQL spiegata dalle domande di un collega: migrazione cross-version, CDC verso data warehouse, configurazione passo-passo.
PostgreSQL ENUM vs CHECK vs lookup table: ALTER TYPE ADD VALUE costa zero, rimuovere un valore costa una migration. Tre strade, un caso reale telco.
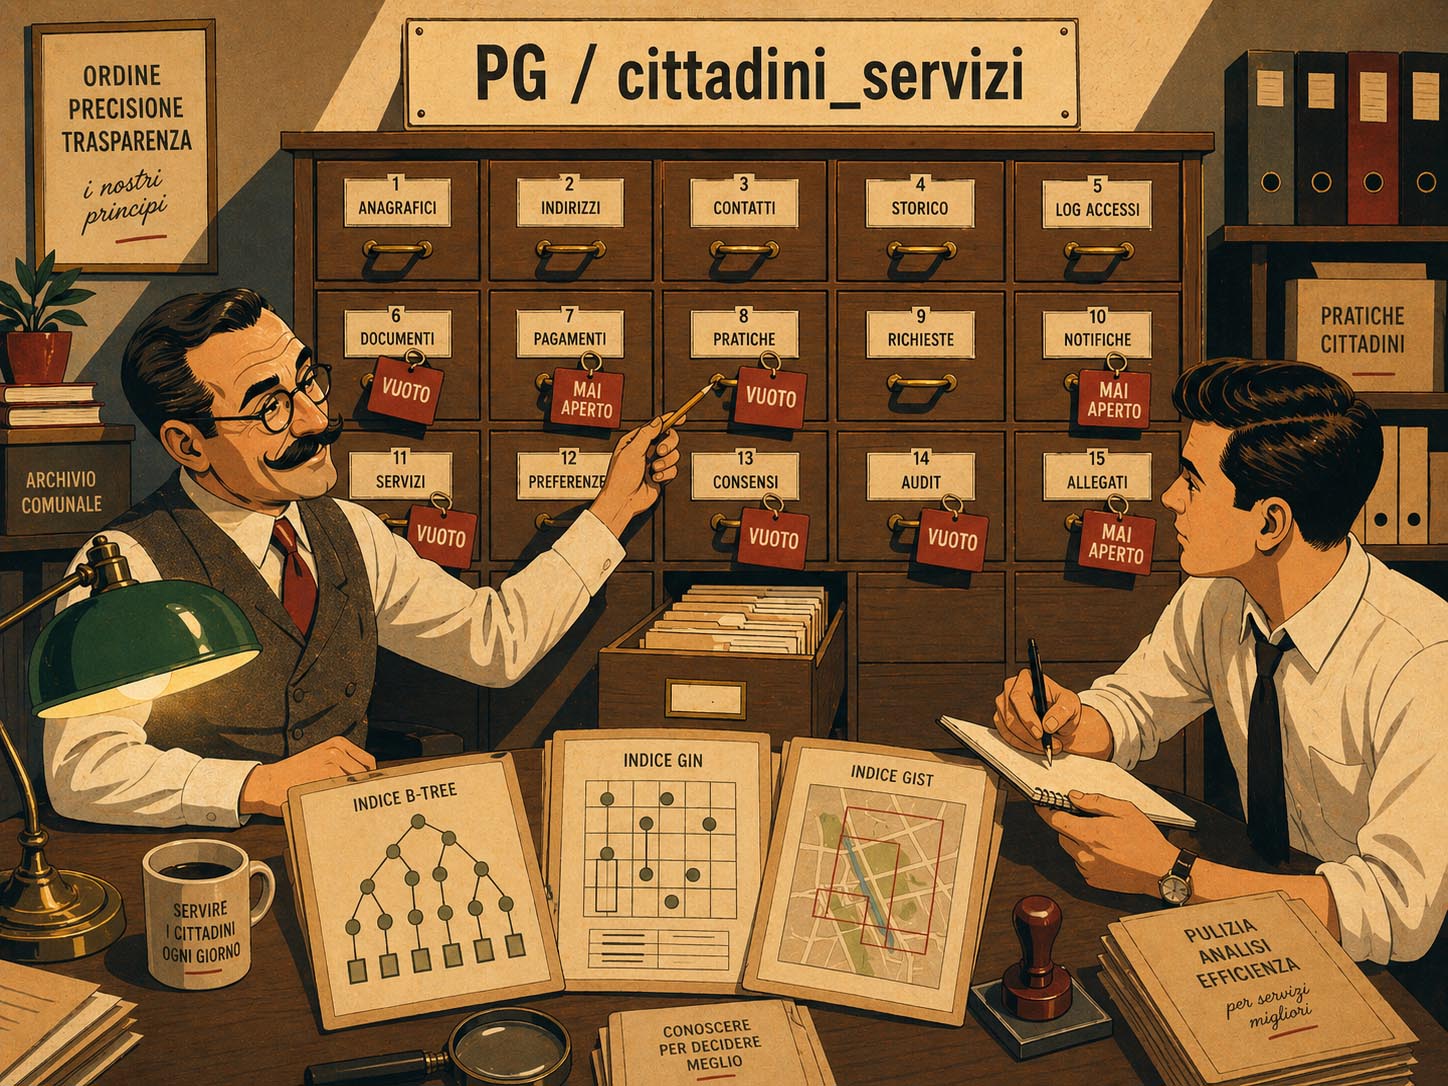
PostgreSQL: trovare e rimuovere indici inutilizzati con pg_stat_user_indexes. Caso reale: tabella con 15 indici di cui 8 mai usati.
PostgreSQL pg_stat_statements: l'estensione di diagnosi query da installare per prima. Trovare le tre query che consumano l'80% delle risorse.
PostgreSQL VACUUM e autovacuum: diagnosi del bloat su database da 200 GB, lettura di pg_stat_user_tables e tuning senza disabilitare nulla.
PostgreSQL ROLE: utenti e ruoli sono lo stesso oggetto. Modello mentale, GRANT, NOINHERIT e creazione di un account read-only manutenibile.
Ottimizzazione PostgreSQL: LIKE '%valore%' genera full scan. Uso di pg_trgm e indice GIN per trasformare un wildcard search in lookup veloce.
128 MB di default su 32 GB di RAM: diagnosi, dimensionamento, buffer pool instances e warm-up dopo restart. Numeri reali prima e dopo il fix.
Due ticket di monitoraggio, due nodi fuori dal cluster Galera in sequenza. Diagnosi passo per passo: wsrep_cluster_size, quorum, SST/IST, bootstrap di emergenza.
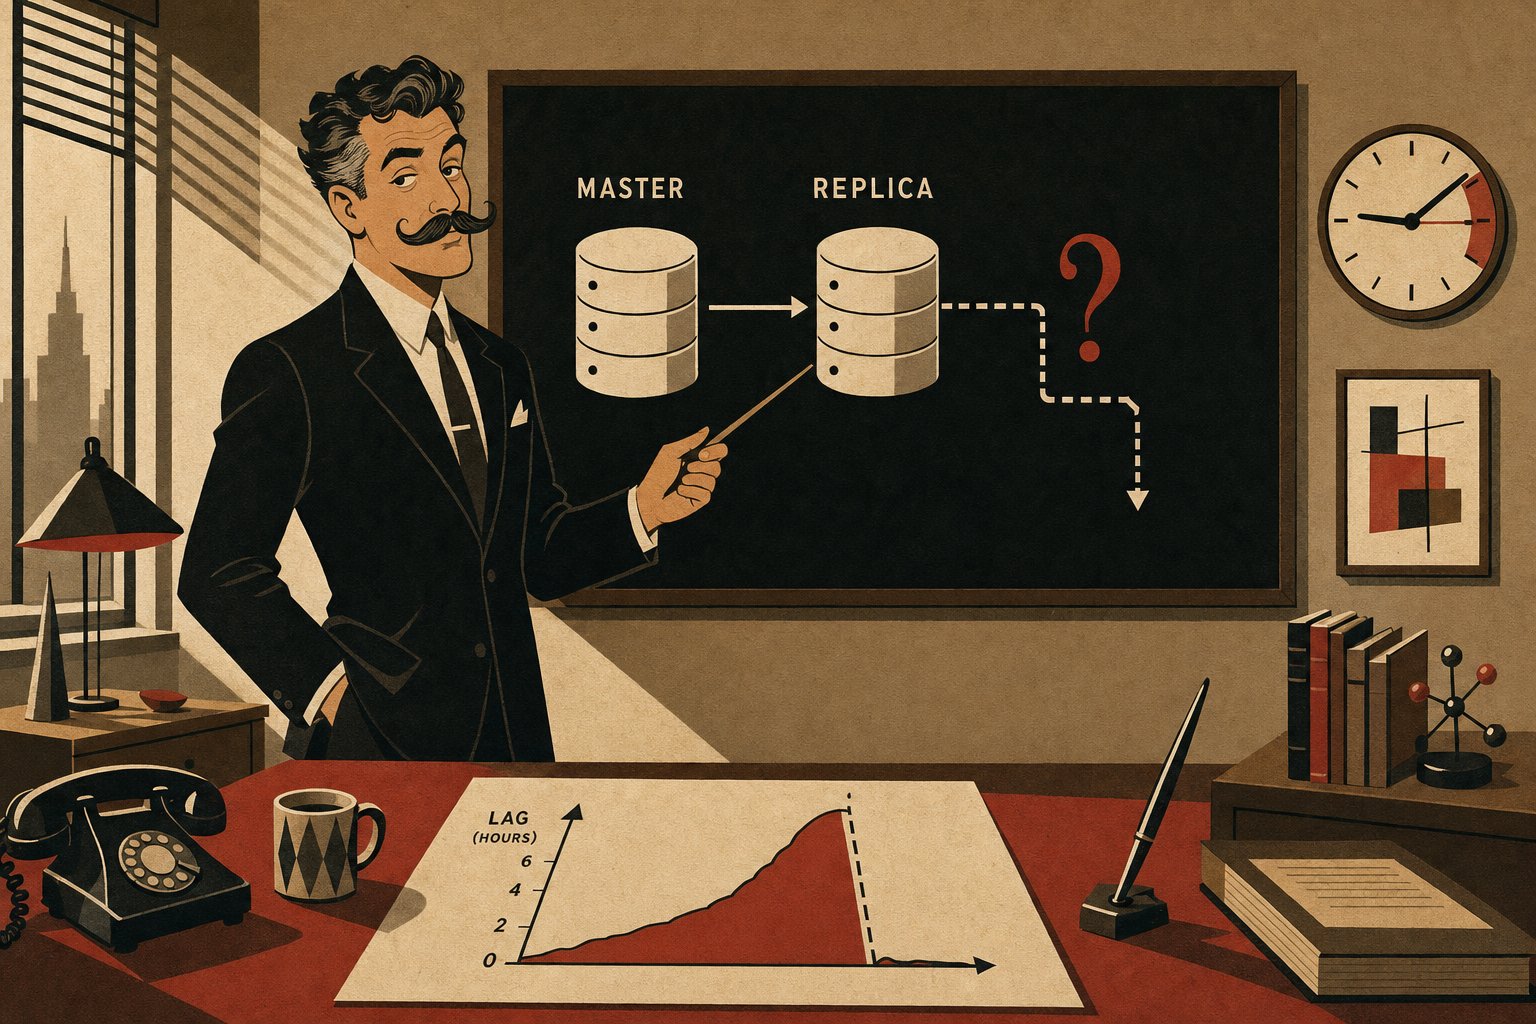
Replica MySQL con 4 ore di lag e nessun alert. Come funziona il binlog, perché Seconds_Behind_Master mente, e come il parallel replication risolve davvero.
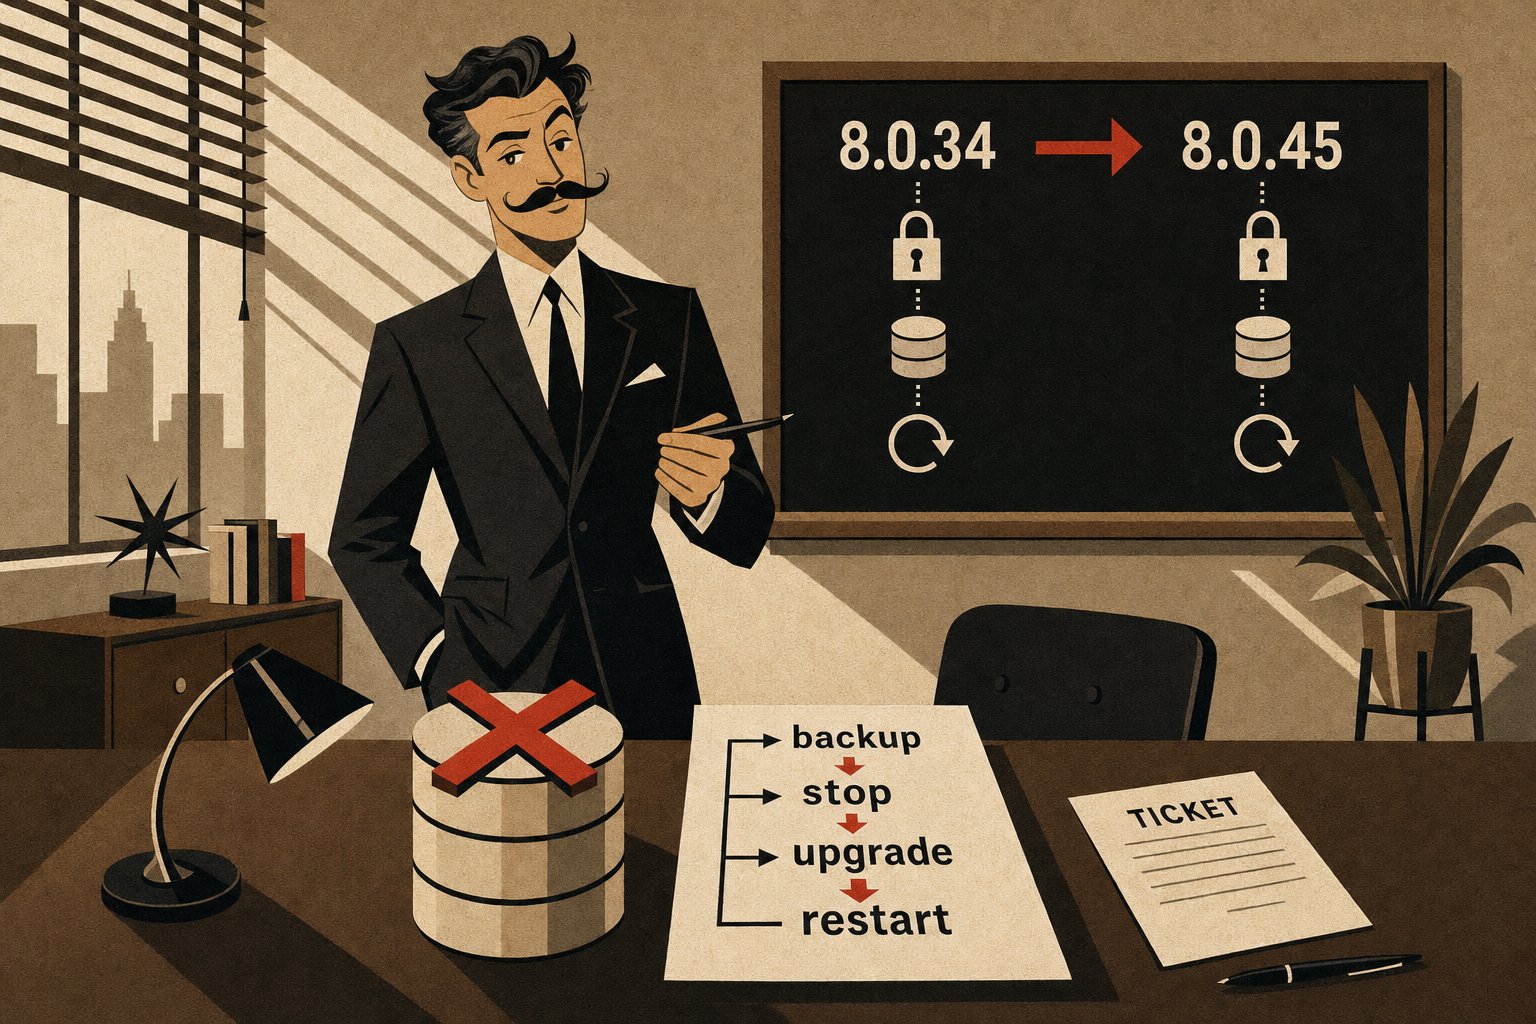
View rotte, GTID warning, check replica prima dello stop: il workflow reale di un patching MySQL 8.0 su RHEL 8.3, con query riutilizzabili e tutti gli errori del campo.
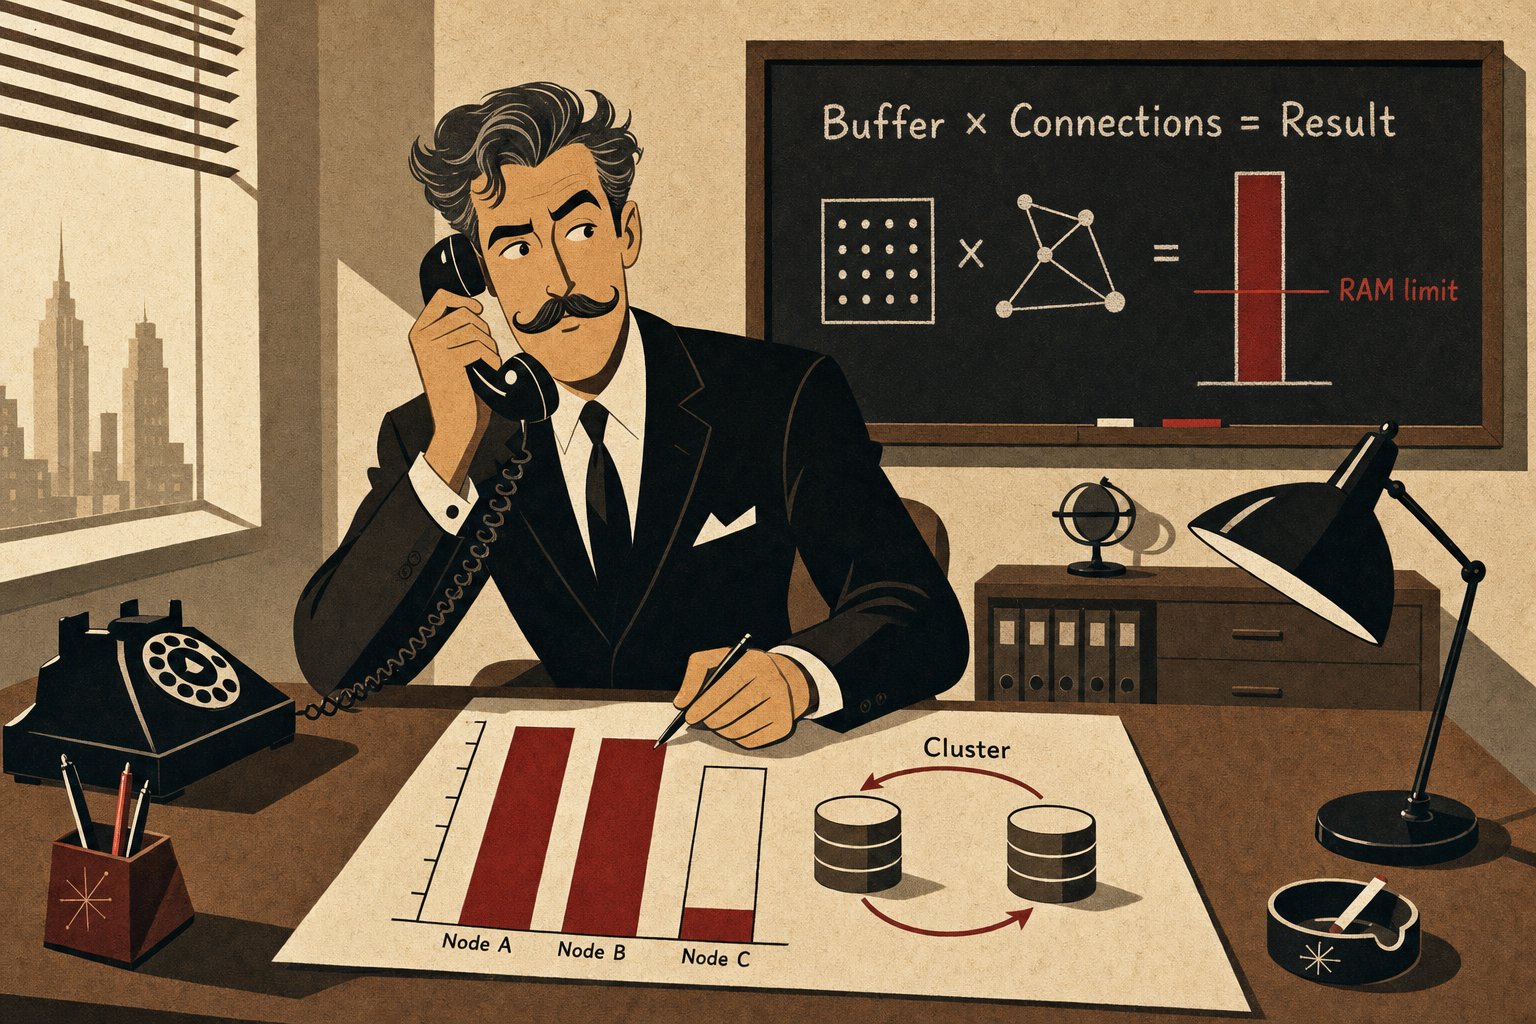
Swap al 100% su un cluster MySQL InnoDB 3 nodi in produzione: diagnosi, la matematica dei buffer per thread, fix e rolling restart a zero downtime.
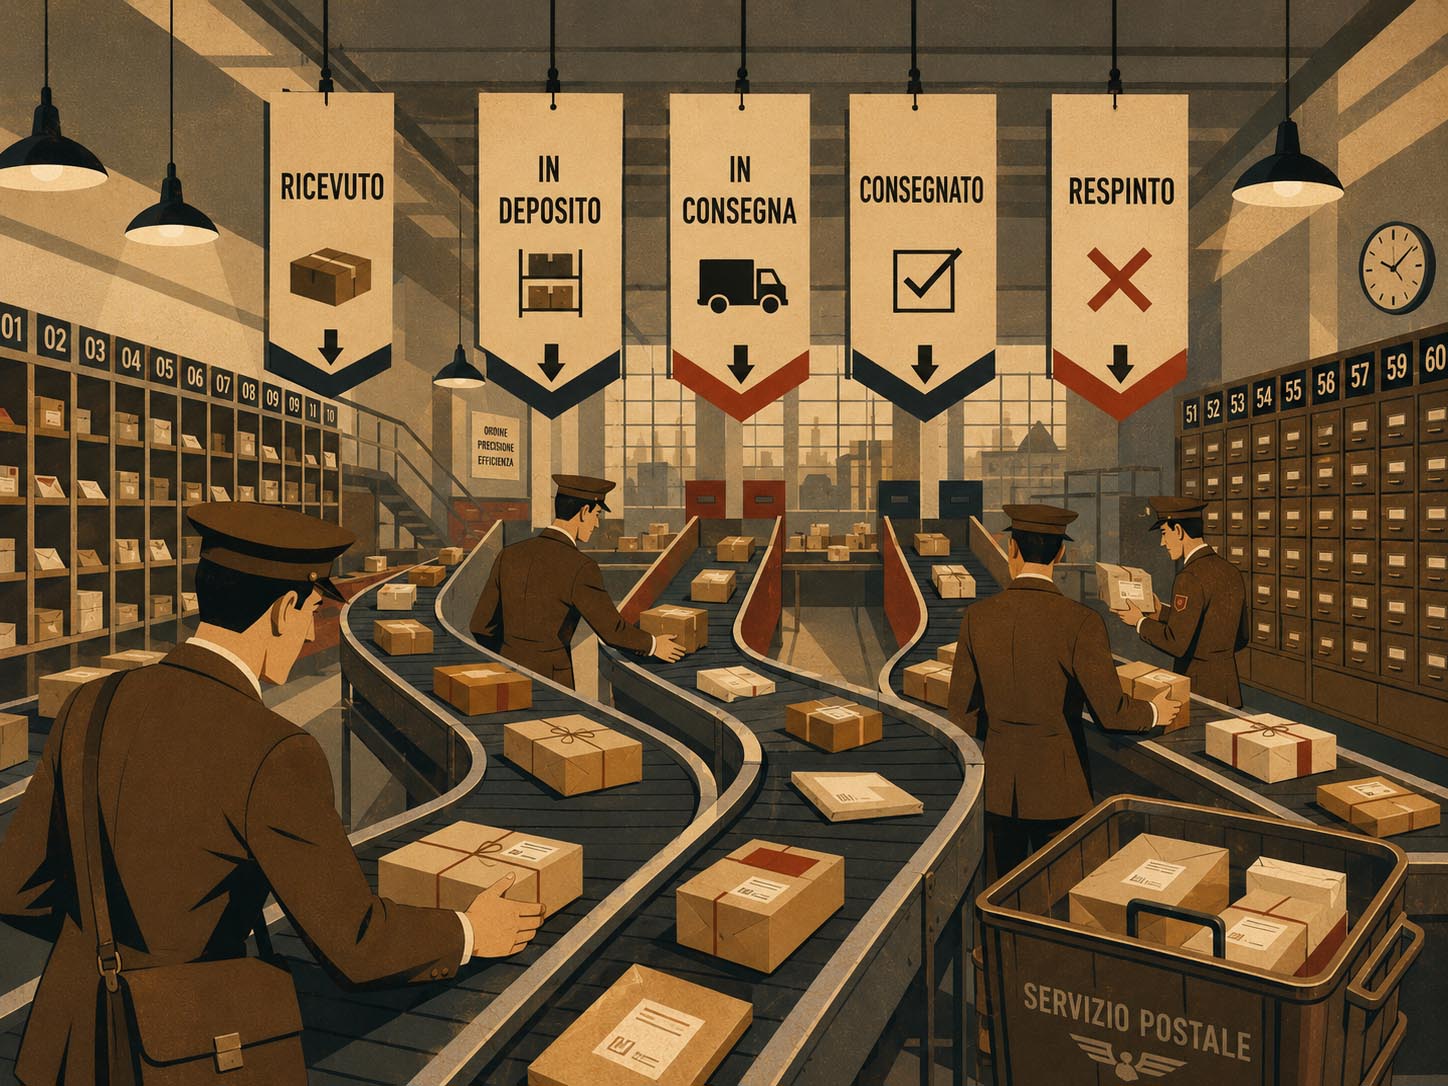
MySQL ENUM vs CHECK constraint vs tabella di lookup: tre strade per modellare un'enumerazione. Vantaggi, limiti e caso reale di tracking spedizioni.
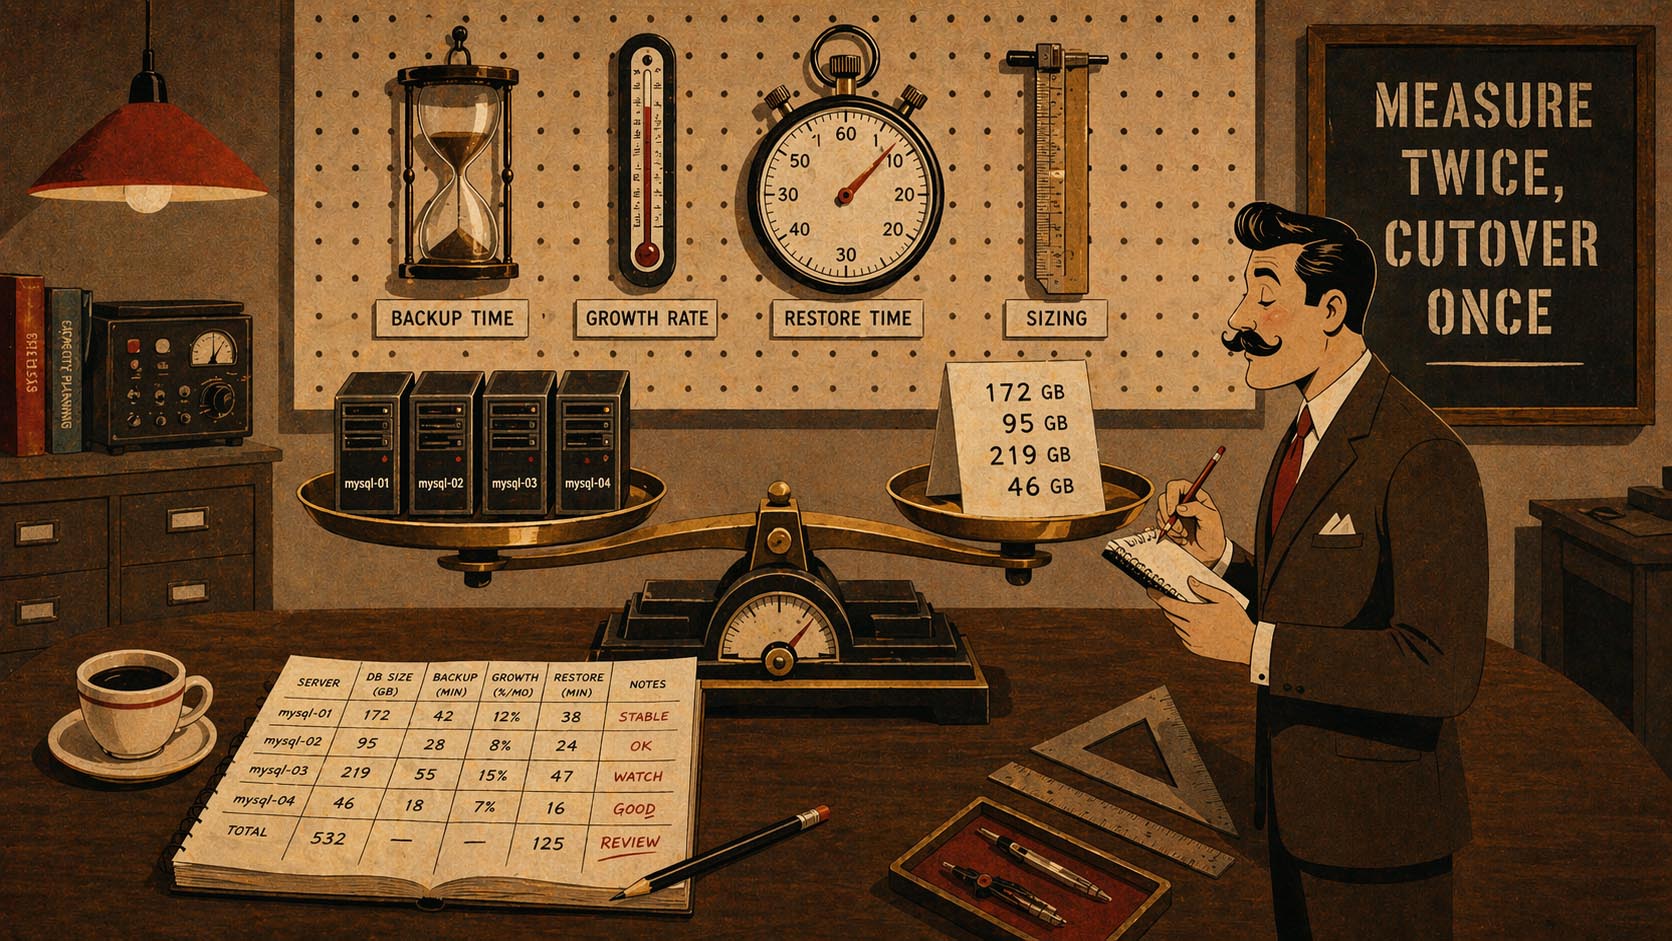
MySQL 8.0 pre-upgrade assessment: misurare dimensioni, crescita, tempi di backup e restore con information_schema. Cifre vere per pianificare.
Inizia a digitare per cercare…
Seleziona un risultato per vedere l'anteprima