Más recursos, misma causa
Por qué añadir CPU, RAM o IOPS rara vez resuelve un database mission-critical que va lento — y qué mirar antes de firmar el presupuesto.
Por qué añadir CPU, RAM o IOPS rara vez resuelve un database mission-critical que va lento — y qué mirar antes de firmar el presupuesto.
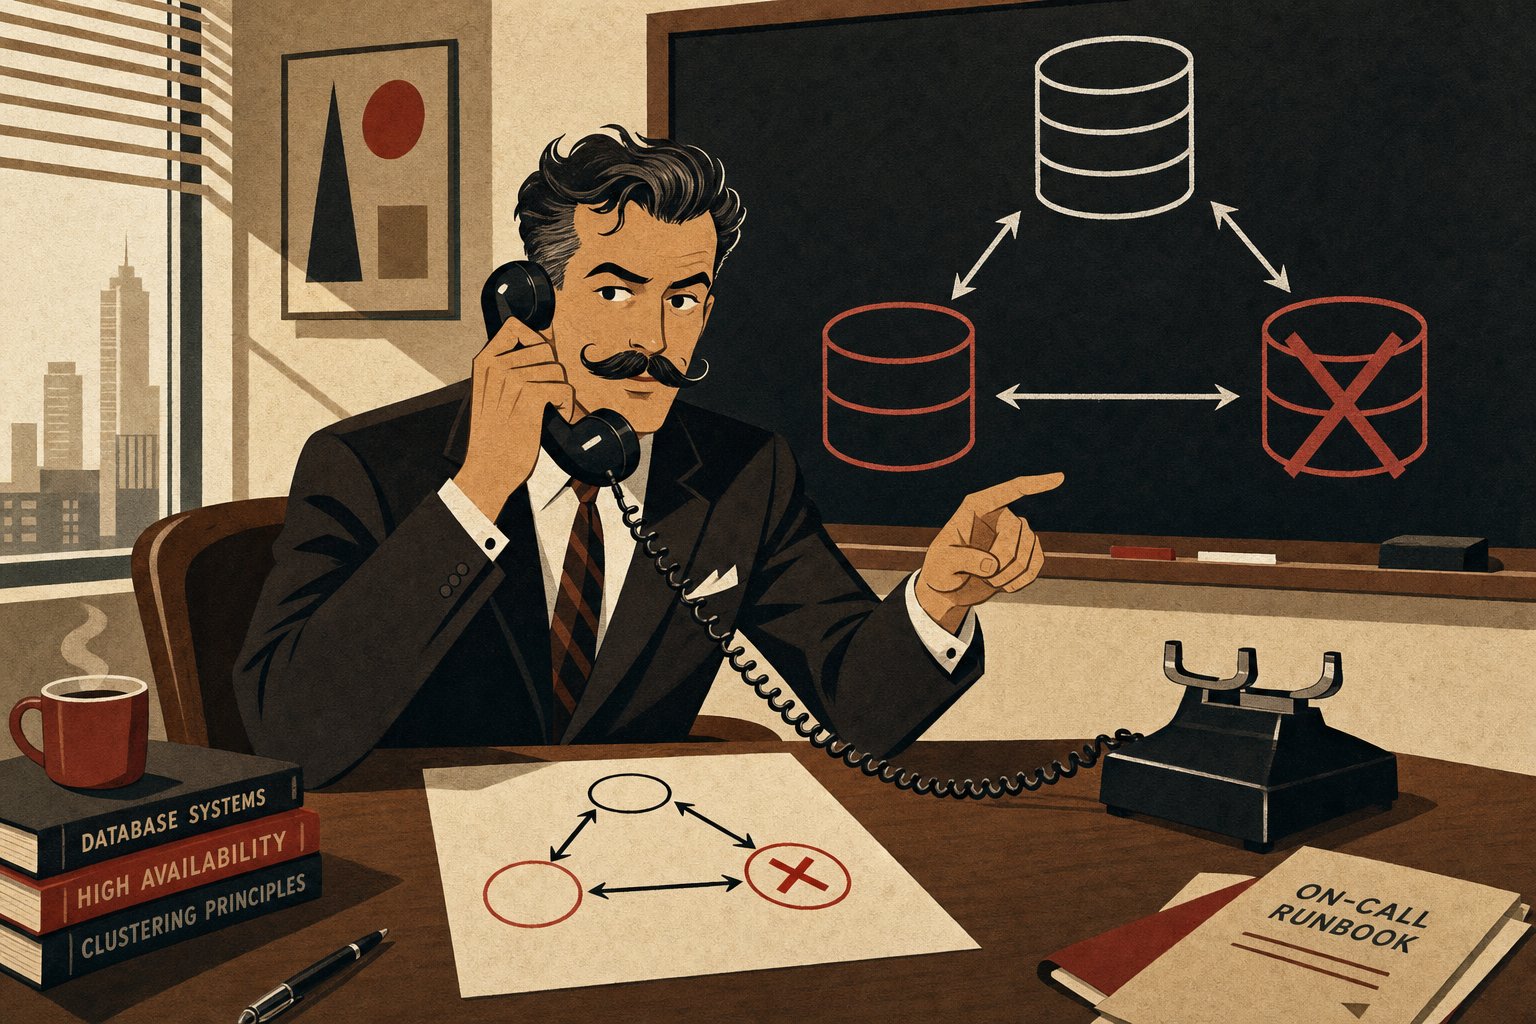
Cómo recuperar un Galera Cluster a 3 nodos cuando caen dos nodos en cascada: diagnóstico, SST vs IST, bootstrap de emergencia y runbook operativo.
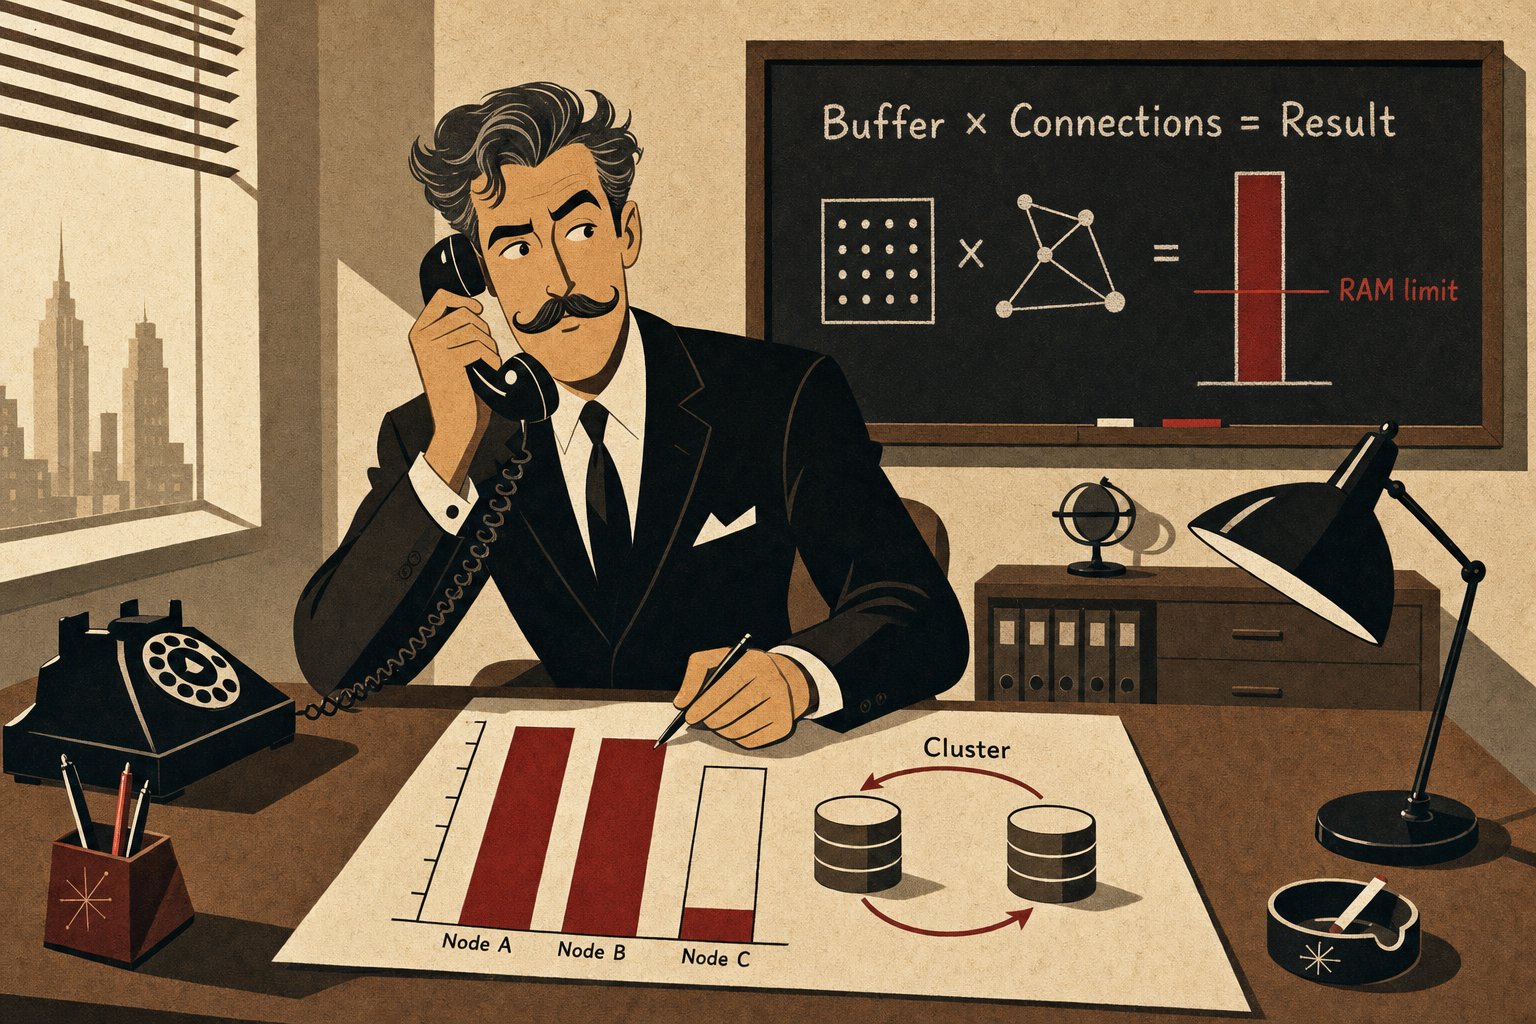
Diagnóstico en producción de un cluster MySQL InnoDB con swap saturado: cómo join_buffer_size a 2 GB por thread colapsa un nodo con 157 GB de RAM.
Diagnóstico guiado de ORA-00205 en plena emergencia nocturna: fase MOUNT, control file, SPFILE, redo log. Método práctico para DBA Oracle de guardia.
Empieza a escribir para buscar…
Selecciona un resultado para ver la vista previa