- Ivan Luminaria/
- Database Strategy/
- Liderazgo técnico y proyectos/
- Lift-and-shift ahora, optimizamos después: cuánto cuesta el «después» en un sistema validado/
Lift-and-shift ahora, optimizamos después: cuánto cuesta el «después» en un sistema validado
Por qué en una migración cloud la fase más económica para repensar la base de datos es la anterior al traslado — y qué ocurre cuando, tras el go-live, cada modificación debe pasar por el change control GxP.
El business case era correcto #
El documento que el comité de inversiones había aprobado estaba bien construido. Una empresa farmacéutica de tamaño medio, tres plantas de producción, un data center propio con el contrato de hosting a punto de vencer y un parque de servidores que había llegado al fin de su soporte. En el centro, una base de datos Oracle de unos 6 TB sobre la que corren el sistema de gestión de calidad, el LIMS de los laboratorios de control y la reportística de liberación de lotes. El plan era claro: trasladar todo a infraestructura cloud en nueve meses, lift-and-shift, misma versión, misma arquitectura aplicativa, sin reescrituras. Optimización y modernización en una segunda fase, ya prevista en el presupuesto del año siguiente.
La decisión tenía una lógica sólida, y quienes la tomaron no erraron en los cálculos que tenían delante. El contrato del data center imponía la fecha. La reescritura aplicativa habría requerido una nueva validación completa de los sistemas, con plazos incompatibles con el vencimiento. «Primero salimos del data center, luego optimizamos con calma» era, en aquella reunión, la frase más razonable posible.
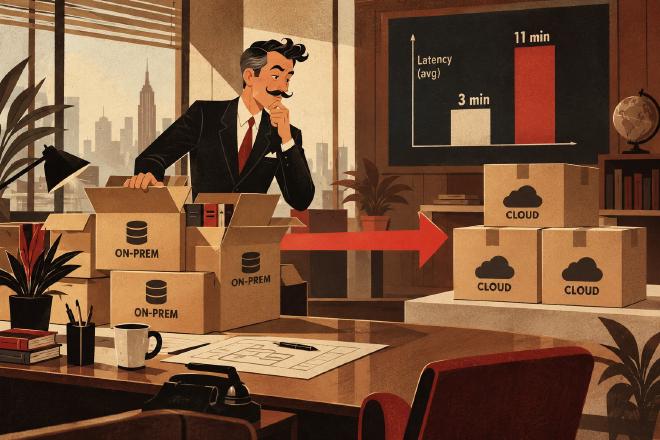
El go-live llegó en plazo. El sistema funcionaba. Seis semanas después, el director de Calidad preguntó por qué el informe de liberación de lotes, que antes tardaba tres minutos, ahora tardaba once.
Once minutos, y de dónde vienen #
La respuesta no estaba en la base de datos. Los servidores aplicativos del LIMS habían permanecido en una de las plantas — conectados a instrumentos de laboratorio que no podían moverse — mientras la base de datos había ido a la nube. Una decisión sensata sobre el papel: la aplicación se quedaba cerca de los instrumentos, la base de datos iba donde costaba menos gestionarla.
El informe de liberación, escrito quince años atrás para una LAN, no ejecutaba una consulta: ejecutaba cientos de miles, una por cada fila de resultado analítico, en un bucle aplicativo. En el AWR la firma es inconfundible: la estadística SQL*Net roundtrips to/from client muy elevada respecto a las user calls útiles, y el tiempo dominado por el evento SQL*Net message from client — la base de datos parada esperando al cliente.
Los números, una vez alineados, son sencillos:
- aproximadamente 180.000 round-trips por ejecución del informe;
- en LAN, latencia de unos 0,3 ms por round-trip → 54 segundos de red sobre tres minutos totales;
- entre la planta y la región cloud, unos 3 ms → 540 segundos solo de red, nueve minutos;
- el resto del trabajo (unos dos minutos) idéntico antes y después.
Tres minutos se convierten en once sin que una sola consulta haya empeorado. La base de datos, en cloud, era incluso más rápida. (Cifras representativas de contextos análogos — A VERIFICAR antes de la publicación: la latencia efectiva planta-región y el conteo de round-trips deben calibrarse sobre un caso documentable.)
Mientras tanto, la factura mensual había llegado a un 35% por encima del business case. Las instancias se habían dimensionado sobre el pico histórico on-premises, con margen, porque nadie quería arriesgar el rendimiento en un sistema validado; el almacenamiento se había elegido en el tier que garantizaba los IOPS del antiguo array; los backups se habían replicado con la misma política de retención de antes, ahora pagada por gigabyte. (Porcentaje A VERIFICAR.)
Por qué el «después» cuesta más que el «antes» #
Hasta aquí es una historia que cualquiera que haya hecho una migración cloud reconoce: una aplicación chatty, una latencia que antes era invisible, un dimensionamiento prudente. La parte específica del sector farmacéutico llega cuando se abre la fase dos.
La base de datos y el LIMS son sistemas informatizados validados: soportan decisiones GxP, y están sujetos al EU GMP Annex 11 y, para los productos destinados al mercado americano, al 21 CFR Part 11. Cada modificación a un sistema validado pasa por change control, evaluación del riesgo, pruebas documentadas, aprobación de Calidad. Reescribir el bucle del informe en una consulta set-based, mover el cálculo al lado de la base de datos, revisar el dimensionamiento de las instancias: cada una de estas modificaciones, con el sistema en producción, abre un ciclo de revalidación.
Antes de la migración, esas mismas modificaciones habrían viajado dentro de la validación de la propia migración — que había que hacer de todos modos. El paquete de pruebas, el protocolo, las firmas: todo estaba ya previsto y pagado. Tras el go-live, cada intervención se convierte en un proyecto independiente, con su propio protocolo, sus firmas, su ventana de parada acordada con producción.
Este es el punto que el business case no podía ver. La fase dos estaba presupuestada como trabajo técnico. En la realidad es un trabajo de validación, y su coste es proporcional al número de intervenciones, no a su dificultad técnica. En el caso concreto, la estimación de la fase dos pasó de cuatro a once meses de calendario cuando Calidad alineó los cambios necesarios. (A VERIFICAR.)
Nadie, en esta historia, trabajó mal. El equipo de infraestructura migró exactamente lo que se le había pedido, en plazo. El equipo aplicativo mantuvo el código invariado para no invalidar la validación. Calidad hizo su trabajo. El punto débil estaba en la frase misma: «optimizamos después» presupone que el después tiene el mismo coste que el antes.
La mudanza y las cajas cerradas #
Quien se ha mudado al menos una vez conoce el fenómeno. La mudanza tiene una fecha, y la fecha manda. Las últimas dos semanas las cajas se llenan sin elegir: «me lo llevo todo, luego lo organizo con calma en la casa nueva». En la casa nueva, las cajas sin abrir van al trastero. Siguen allí cinco años después, y ahora el trastero se paga por metro cuadrado.
El momento en que elegir cuesta menos es antes de cerrar la caja — cuando ya la tienes en la mano. Después, abrirla requiere bajar al trastero, mover las demás, encontrar el momento. En la nube el trastero se paga cada mes; en un sistema validado, para abrir una caja hace falta también la firma de alguien más.
Cuatro preguntas antes de escribir «fase dos» en el plan #
Ninguna de estas preguntas sirve para renunciar al lift-and-shift, que sigue siendo a menudo la elección correcta cuando hay una fecha límite real. Sirven para decidir qué llevar tal como está y qué vale la pena repensar mientras el coste de repensarlo es todavía el de la migración.
1. ¿Qué componentes se quedan fuera de la nube, y cuánto hablan con la base de datos? Una aplicación que se queda en planta y una base de datos que va a la región convierten cada round-trip en latencia WAN. Contar los round-trips de las transacciones críticas — desde el AWR, antes de la migración — cuesta una tarde. Multiplicarlos por la latencia medida entre los dos sitios da el tiempo que el sistema perderá, antes de que lo pierda.
2. ¿El dimensionamiento se calculó sobre la carga medida o sobre el miedo a la carga? En el hardware antiguo se compraba una vez para cinco años, y el margen era gratuito tras la compra. En cloud el margen se paga cada hora. Dimensionar sobre la carga medida, con un plan explícito para crecer, es una decisión diferente a dimensionar «como antes, con un poco de seguridad».
3. ¿Qué intervenciones de la fase dos tocan un sistema validado, y cuánto cuesta validarlas después en lugar de durante? Es la pregunta que desplaza la discusión del plano técnico al económico. Si la respuesta es «las validaríamos de todos modos durante la migración», la fase dos cuesta una fracción de lo que costará con el sistema en producción.
4. ¿Quién firma la fase dos, y con qué presupuesto ya aprobado? Una fase dos sin propietario y sin presupuesto deliberado es, en la práctica, un trastero. Nombrar a quien responde de ella y con qué recursos — antes del go-live — es la única manera de evitar que se convierta en una intención.
Lo que este artículo deja fuera #
Dos temas merecen un artículo propio y aquí quedan deliberadamente fuera: el licensing de Oracle en cloud (las reglas de conteo de vCPU en los hyperscalers cambian bastante los números del business case) y la residencia de datos para los datos de calidad y farmacovigilancia. Quien los ha afrontado en una migración GxP tiene probablemente una parte de esta historia que aquí falta.
Una pregunta para llevarse #
La próxima vez que un plan de migración contenga la frase «optimización en una fase posterior», vale la pena preguntarse:
«¿Cuántos round-trips hace nuestra transacción más crítica — y cuánto costará cambiarla después, frente a cambiarla ahora?»
Para quienes ya han atravesado una migración con aplicaciones que se quedaron on-premises y la base de datos en cloud: ¿cuál fue la primera señal de que el «después» iba a costar más de lo previsto?
Glosario #
- Lift-and-shift — Estrategia de migración cloud que traslada sistemas tal como están, sin modificar arquitectura ni código. Minimiza el tiempo de migración pero pospone las optimizaciones.
- GxP — Conjunto de regulaciones y directrices (Good Practice) aplicables a la industria farmacéutica y de ciencias de la vida: GMP, GLP, GCP. Cualquier sistema que soporte decisiones GxP requiere validación formal.
- Change control — Proceso formal de gestión de cambios en sistemas validados: evaluación del riesgo, documentación, aprobación y registro de cada modificación antes de su implementación.
- AWR (Oracle) — Automatic Workload Repository: instantáneas periódicas de métricas de carga de trabajo, base de los informes AWR y de ADDM. Herramienta clave para diagnosticar problemas de rendimiento.
- Round-trip (SQL*Net) — Ciclo completo de comunicación entre cliente y servidor de base de datos: envío de petición, procesamiento, devolución de resultado. En aplicaciones chatty, su acumulación sobre latencia WAN es la causa más frecuente de degradación de rendimiento.