Más recursos, misma causa
Por qué añadir CPU, RAM o IOPS rara vez resuelve un database mission-critical que va lento — y qué mirar antes de firmar el presupuesto.
El presupuesto sobre la mesa #
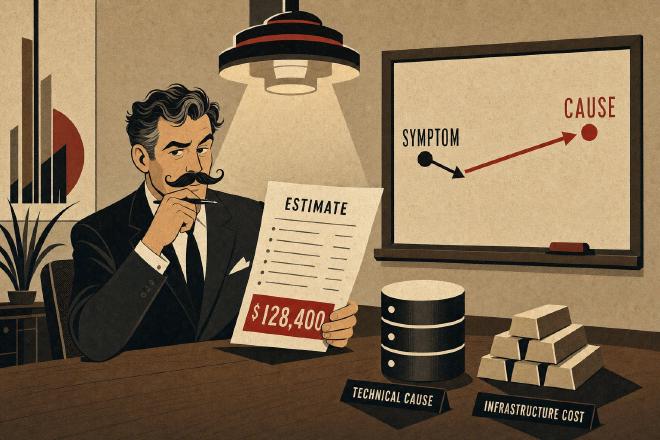
Hay un momento que se repite casi idéntico en bancos, aseguradoras, utilities y telcos. Un CIO — o un CTO, o un Head of Data Platform — mira un presupuesto para una actualización de infraestructura. Puede ser una nueva Exadata, una PDB más grande en OCI, una migración a una instancia cloud con más IOPS garantizados, RAM adicional en una máquina física que ya no tenía margen.
El número en la esquina inferior derecha oscila entre unos cientos de miles y varios millones de euros. El razonamiento escrito dos páginas más arriba suena razonable: el sistema está bajo presión, el equipo dice que hace falta más capacidad, el vendor lo confirma, los SLA con los clientes enterprise están a punto de incumplirse. El board quiere una respuesta rápida, el CFO quiere saber cuándo se firma.
La reacción instintiva, en ese momento, es aprobar.
Es instintiva por un motivo comprensible: añadir recursos es la decisión más fácil de explicar en veinte segundos en el comité de dirección. Es medible (más gigas, más cores, más IOPS), es comparable (el vendor te manda el listado de precios), es trazable (a fin de año el CFO sabe exactamente qué se ha gastado). Da la impresión precisa de haber hecho algo.
Y en una parte de los casos — probablemente menos de lo que se cree, pero no cero — funciona de verdad. Si el sistema estaba realmente subdimensionado respecto a la carga, más capacidad lo resuelve. Sobre el papel es la elección racional.
El problema es lo que ocurre en los otros casos.
Lo que pasa cuando no era la causa #
Un database que va lento es, prácticamente siempre, un síntoma. El síntoma aparece en un punto concreto: una query nocturna que supera la ventana, un batch analítico que tarda tres veces más, una aplicación front-end que responde tarde en horas pico, un incident esporádico que se resuelve solo al cabo de diez minutos. La causa real, en un sistema construido capa a capa durante diez o veinte años, casi siempre está un nivel más allá del punto donde aparece el síntoma.
Puede ser un plan de ejecución degradado por una estadística desactualizada. Puede ser un modelo de datos que ha crecido más rápido de lo que se diseñó — una tabla que pasó de 200 millones a 2.000 millones de filas con los mismos índices de hace diez años. Puede ser una configuración de storage modificada seis meses antes que desplazó un fichero a un tier más lento. Puede ser una query nueva, introducida por una aplicación que llegó el año pasado, que escanea una tabla grande cada tres minutos sin que nadie se haya dado cuenta. Puede ser una configuración RAC que por debajo de cierto nivel de concurrencia desencadena wait events transversales que no aparecen en el monitoring diario.
En todos estos casos, añadir recursos produce un efecto medible y temporal. El sistema, con más CPU o más IOPS, consigue enmascarar el cuello de botella durante semanas, a veces un par de meses. Luego el cuello de botella se desplaza. El plan degradado no ha cambiado, la tabla sigue creciendo, la query mal diseñada sigue ejecutándose — y mientras tanto la carga también ha crecido, como siempre crece en los sistemas reales. El síntoma vuelve, en un punto ligeramente distinto, a menudo agravado por el hecho de que ahora la infraestructura es más cara de mantener encendida.
Cuando ocurre, la conversación interna se convierte en un segundo problema. Porque el CIO que acaba de firmar ese presupuesto tiene que explicar al board que el problema que el upgrade debía resolver ha vuelto. Y el board — con razón — hace la pregunta que el CIO más teme: "¿y ahora qué? ¿Otro upgrade?".
Un caso, y los números al lado #
Un ejemplo concreto, con sector y órdenes de magnitud (números reales, cliente anonimizado). Un batch analítico crítico en un contexto telco, con Oracle en OCI y Autonomous Database, requería cuatro horas cada noche. Durante los tres años anteriores, la respuesta había sido: más CPU, más IOPS, más memoria SGA. En cada ronda el batch bajaba veinte minutos durante unas semanas, luego volvía al umbral de las cuatro horas. Un análisis cross-layer — planes de ejecución, wait events históricos en AWR, correlación con el crecimiento de las tablas fuente, revisión de los joins más costosos, reescritura dirigida de tres pasos del PL/SQL — llevó el tiempo de batch por debajo de los treinta minutos. Los recursos de infraestructura se quedaron igual que al principio.
En otro contexto, un Data Warehouse sobre cuatro países europeos con más de 60.000 líneas de PL/SQL, el patrón era similar: la ventana de ingestion nocturna se alargaba trimestre a trimestre, y la petición recurrente era más máquina. Tras una intervención sobre el modelo de datos, los índices y la reorganización de algunas tablas de staging, la ingestion diaria completa volvió a completarse en menos de dos horas — sin tocar la parte de infraestructura.
El punto no es que el hardware nunca sea necesario. El punto es que, cuando la causa real está en el software, en el modelo o en el plan, el hardware compra tiempo. El tiempo es útil — a veces es indispensable para llegar al próximo fin de semana de mantenimiento — pero es tiempo, no solución. Y cuando se compra creyendo haber resuelto el problema, el segundo incident llega en el peor momento, con la pregunta: “después del primero, ¿qué hicimos?”.
La línea 330 sigue ahí #
Hay una imagen que uso a menudo, y que quien empezó a programar hace cuarenta años entiende sin explicaciones. El Commodore 64, cuando encontraba un error, mostraba un mensaje amable: ?SYNTAX ERROR IN 340. Ibas a revisar la línea 340 y era perfecta. La causa estaba en la 330 — un punto y coma que unos minutos antes se había convertido en dos puntos. (He contado con detalle esa experiencia — y cómo se ha transformado con los años en el oficio de hoy — en El doctor loco: un Commodore 64, una puerta cerrada y el oficio de entender.)
A los niños de entonces esa experiencia les enseñaba un principio que hoy sigue vigente en los sistemas enterprise: el lugar donde el ordenador se queja casi nunca es el lugar donde está el error. Añadir hardware donde el sistema se queja es el equivalente adulto de modificar la línea 340. El programa sigue sin funcionar, porque la línea 330 todavía está esperando.
En los databases mission-critical el mecanismo es el mismo. Solo cambian las dimensiones. Y el coste del error.
Las preguntas que preceden a la firma #
Ninguna de estas preguntas pretende convencer a nadie de no firmar un upgrade. En algunos casos, lo repito, el upgrade es la respuesta correcta y hay que hacerlo. Las preguntas sirven para decidir caso a caso si realmente lo es, antes de que el presupuesto se convierta en un pedido.
1. ¿Qué cambió en los días o semanas que precedieron al primer síntoma? Un sistema que ha funcionado durante años y ahora va lento tiene, casi siempre, un evento desencadenante. Un parche, una release de aplicación, una estadística recalculada, una tabla que ha superado un umbral de crecimiento, un cambio de configuración de storage, un nuevo módulo que ha empezado a llamar al database de forma diferente. Si la línea temporal de ese qué cambió no se ha reconstruido de forma creíble, el upgrade está comprando tiempo sobre una causa todavía desconocida.
2. ¿Qué evidencia técnica respalda la hipótesis de que hace falta más capacidad? Un AWR con evidencia clara de que los wait events dominantes son CPU-bound o I/O-bound respalda un upgrade. Un ASH que muestra sesiones bloqueadas en locks de aplicación, o un plan de ejecución degradado que hace un full scan sobre una tabla indexable, indica otro camino. La diferencia se lee en los datos, no en las sensaciones.
3. ¿Quién, dentro del equipo o junto al equipo, está mirando el sistema en su conjunto? El DBA ve el database, el desarrollador ve la aplicación, el sysadmin ve la infraestructura, el equipo de red ve la red. Cada uno ve correctamente su pieza. La causa real, cuando es transversal, está en la intersección — y ninguno de estos roles, por definición, tiene visibilidad completa sobre esa intersección. La pregunta “¿quién lee el sistema en su conjunto?” no es retórica: si la respuesta es “nadie de forma estructurada”, el upgrade está decidiendo antes de haber entendido.
4. Si el upgrade solo funcionara tres meses, ¿cuál sería el plan B? Es la pregunta que los CIO más experimentados hacen al final. Si la respuesta es “haremos otro”, la estrategia es clara y vale el riesgo. Si la respuesta es “no lo hemos pensado”, conviene detenerse un momento.
La comparación que el CFO entiende en treinta segundos #
Un Health Check estructurado — cinco jornadas de análisis cross-layer, un informe con línea temporal, evidencias y hoja de ruta con prioridades — tiene un coste que es un orden de magnitud inferior al presupuesto medio de un upgrade de infraestructura enterprise (indicativamente €8K para el Health Check frente a €300K–€500K de un upgrade Exadata de tamaño medio — cifras de referencia A VERIFICAR respecto a los listados específicos del cliente).
La lógica para un CFO es lineal: antes de firmar un gasto de seis cifras, una segunda opinión independiente cuesta una fracción del presupuesto y reduce la probabilidad de firmar dos veces por el mismo problema. No es un descuento en el gasto de infraestructura — es un seguro sobre el hecho de que, cuando llegue la firma, llegue sobre la decisión correcta.
El valor para el CIO es todavía más directo: lleva al board una decisión defendible. “Encargamos un análisis independiente, comparamos sus conclusiones con la propuesta del vendor, la elección final es coherente con ambas” es una frase que cierra el punto en tres líneas de acta. “Firmamos porque el vendor lo sugería” abre otro tipo de conversación — la que el CIO prefiere no tener seis meses después, si el problema vuelve.
Una pregunta para llevarse #
No hay un principio universal sobre el upgrade de infraestructura. Hay contextos en los que es la elección correcta y hay que hacerla sin dudar; hay otros en los que es tiempo comprado caro. La diferencia no está en la tecnología ni en el vendor. Está en la calidad del diagnóstico que precede a la firma.
Si hay un presupuesto importante sobre tu mesa estas semanas, hay una pregunta que vale la pena hacerse antes de aprobarlo:
"¿El análisis que respalda este gasto distingue de forma creíble entre la causa real del problema de rendimiento y el punto donde ese problema se manifiesta — o está asumiendo que coinciden?"
Si la respuesta tiene alguna vacilación, la línea 330 podría seguir ahí.