- Ivan Luminaria/
- Database Strategy/
- Liderazgo técnico y proyectos/
- La IA muestra el síntoma. El board pregunta por la causa./
La IA muestra el síntoma. El board pregunta por la causa.
La IA muestra el síntoma. El board pregunta por la causa. #
Qué hace, realmente, la observability moderna — y qué sigue siendo necesario cuando la pregunta llega desde arriba.
La pregunta del lunes por la mañana #
Hay una pregunta que todo CIO conoce bien, y que llega casi siempre en las veinticuatro horas posteriores a un incident serio. La hace el board, la hace el CFO, a veces la hace el consejero delegado en el pasillo. Suena así, con pequeñas variaciones: «¿pero no habíamos contratado Datadog el año pasado? ¿No habíamos renovado Dynatrace? ¿No habíamos activado Ops Insights en OCI? ¿Cómo es posible entonces que no nos haya avisado?».
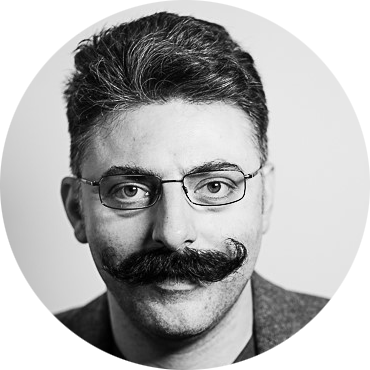
La respuesta honesta es incómoda, porque obliga a decir dos cosas al mismo tiempo. La primera: la herramienta funcionó. El gráfico estaba ahí, las métricas estaban registradas, las alertas estaban configuradas. La segunda: la herramienta no entendió lo que estaba pasando, porque entender no era su trabajo. Su trabajo era mostrar. Mostró — con regularidad, con precisión. Nadie en el equipo leyó lo que mostraba como señal de una cadena que se estaba componiendo.
Quien presenta el balance al board tiene en ese momento dos caminos. Puede dejar que la narrativa se convierta en «la herramienta nos ha fallado» — y volver a procurement con la solicitud de otra herramienta, quizás más cara, quizás con más inteligencia artificial declarada en el material comercial. O puede tomarse una tarde para explicar al board qué hace y qué no hace, realmente, la observability moderna de la que se ha dotado. El segundo camino es más exigente, pero devuelve al CIO el control de la narrativa — que es lo que el board está buscando de verdad cuando formula esa pregunta.
Qué muestra una herramienta, qué reconstruye una persona #
Datadog, Dynatrace, Grafana, Splunk, New Relic, OCI Ops Insights, Oracle Cloud Observability son — cada uno con su propia calidad, que es real — extraordinarios recolectores de señales. Registran decenas de miles de métricas por segundo, correlacionan series temporales, aplican modelos estadísticos que identifican anomalías con un nivel de precisión impensable hace diez años. En muchos escenarios el valor que aportan es altísimo: alertas operativas que llegan antes de una saturación previsible, dashboards que consolidan en una sola vista lo que antes requería ocho consolas separadas, baselines que reconocen el comportamiento normal de un sistema y señalan cuándo se desvía.
El punto en el que estas herramientas dejan de sustituir a una persona no es un límite de calidad del producto — es un límite estructural del tipo de información que devuelven. Un gráfico muestra que la CPU ha subido, que la latencia de disco ha aumentado, que un wait event se ha vuelto dominante, que una query ha cambiado su plan de ejecución. Un modelo de AIOps, en los casos más sofisticados, señala que tres o cuatro de estos fenómenos están correlacionados en el tiempo. La correlación no es la cadena causal. La cadena causal es una historia: un paquete de estadísticas fue recalculado el 14 de septiembre a las 02:17 por el job nocturno, el nuevo plan de ejecución para la query X empezó a hacer full scan sobre una tabla que había crecido hasta 1.800 millones de filas en los tres meses anteriores, la contención sobre enqueue application lock emergió cuando la nueva release de la aplicación — desplegada el 16 — empezó a llamar a esa query cada veinte segundos en lugar de cada cinco minutos, el spike de CPU que el monitoring señaló el 17 es la consecuencia de tres eventos que el monitoring no relacionó entre sí porque nadie le había pedido que buscara este tipo de historia.
Esta historia no la cuenta una herramienta. La reconstruye una persona que sabe qué buscar — porque ha leído miles de cadenas similares, en sistemas similares, en diez o veinte años de oficio. La herramienta le proporciona los datos de partida. Sin la herramienta, la reconstrucción sería más lenta. Sin la persona, no existiría.
Un caso, y el gráfico al lado #
Un entorno telco italiano, Oracle sobre OCI, batch analítico crítico que alimenta una serie de dashboards comerciales. La observability era moderna, la inversión reciente, el AIOps activo. Durante seis semanas consecutivas, el batch — que históricamente completaba en dos horas y media — empezó a desviarse: primero hacia las cuatro horas, luego hacia las cinco. La herramienta señalaba con regularidad: anomalía en CPU wait, crecimiento de I/O read, aumento de latencia de storage en el tier 1. Tres anomalías distintas, correlacionadas temporalmente, ninguna identificada como causa primera — porque ninguna lo era.
El equipo pasó tres semanas detrás de cada anomalía por separado. Más CPU en el nodo, verificación del storage con el proveedor cloud, optimización de las sesiones concurrentes. Cada intervención produjo una mejora de quince o veinte minutos en el tiempo de batch, luego la curva volvió a subir. Ninguna de las tres intervenciones era incorrecta en sí misma: cada una respondía a una de las anomalías señaladas por la herramienta. Ninguna era la respuesta, porque la respuesta no estaba en ninguna de las tres anomalías tomadas por separado.
Un análisis cross-layer de cinco jornadas reconstruyó la cadena. Un plan de ejecución degradado tres meses antes por una estadística que había perdido representatividad sobre una tabla que había crecido un orden de magnitud; una modificación de configuración en el PGA realizada en un ticket urgente en mayo y nunca documentada; una query nueva introducida por una aplicación front-end a principios de julio, que generaba una concurrencia inesperada sobre una estructura de lock interna de la base de datos. Tres eventos distantes en el tiempo, documentados en tres sistemas distintos (el repositorio DBA, el wiki de infraestructura, el release manager de la aplicación), sin correlación automática posible entre ellos para una herramienta de observability — porque eran eventos de naturaleza, período y sistema diferentes.
El batch, tras la revisión conjunta del plan, de la indexación dirigida y del rollback de la modificación PGA, volvió a estabilizarse por debajo de los treinta minutos. La herramienta de observability, a partir de ese momento, se volvió mucho más útil — porque el equipo empezó a leer sus gráficos con un mapa mental. (Los números — 800 millones de registros/día, SLA por debajo de los 500 ms en el servicio downstream — corresponden a los declarados en otras intervenciones sobre contextos análogos; el detalle operativo de este caso específico está anonimizado por confidencialidad contractual.)
El electrocardiograma es un dato, no un diagnóstico #
Hay una imagen que ayuda, especialmente con un board que no es técnico pero ha visto al menos una vez una urgencia hospitalaria. Un electrocardiograma registra con precisión el ritmo del corazón. Reconoce arritmias, señala extrasístoles, muestra la frecuencia instantánea con un nivel de detalle que un médico de hace cincuenta años habría considerado ciencia ficción. Es una herramienta diagnóstica excepcional.
No ve la carótida obstruida. No ve un émbolo que se está formando en una vena profunda. No ve un aneurisma asintomático. El paciente puede tener un ECG impecable y sufrir un ictus treinta segundos después. No es un defecto del ECG — es la naturaleza del ECG: registra una función precisa, no todas las funciones del paciente. El médico lo sabe, y usa el ECG como uno de los exámenes, nunca como el diagnóstico. La anamnesis, la exploración física, otras pruebas dirigidas según la sospecha clínica, la historia del paciente a lo largo de los años: todo eso junto reconstruye el cuadro.
Un sistema mission-critical tiene la misma naturaleza que un paciente complejo. La observability moderna es el ECG — excepcional en lo que hace, ciega en lo que no ve. El AIOps es un ECG que destaca automáticamente las arritmias, útil. El diagnóstico sigue siendo un acto humano, y lo sigue siendo no por nostalgia del pasado sino por la estructura misma del problema: la cadena causal de un sistema estratificado en veinte años requiere mantener juntos el repositorio DBA, los change logs de infraestructura, las release notes de la aplicación, las trazas del sistema operativo, los patrones de carga, las modificaciones al modelo de datos. Ninguna herramienta tiene hoy acceso simultáneo a todas estas fuentes con la capacidad de leerlas de forma integrada — y no por limitaciones de los próximos dieciocho meses, sino por cómo está construido el problema.
Las preguntas que preceden a la confianza en la herramienta #
Ninguna de estas preguntas pretende convencer a nadie de desinstalar la observability — todas sirven para usarla por lo que es, con las expectativas adecuadas desde el board hasta el equipo operativo.
1. ¿La herramienta ve todos los niveles que componen el sistema, o solo aquellos en los que se instaló el collector? Datadog APM cubre magníficamente las aplicaciones instrumentadas; si una parte del flujo crítico pasa por un servicio legacy sin agent, la herramienta tiene un punto ciego. No es un defecto: es una decisión de perímetro que a menudo se olvida después de los primeros seis meses de uso.
2. ¿Quién, en el equipo, interpreta las alertas — y en base a qué modelo mental del sistema? Una alerta que dice «CPU wait anómalo en el nodo 2» significa cosas distintas para un administrador de sistemas, un DBA y un desarrollador. Si no hay una convención interna sobre quién interpreta qué, la herramienta genera ruido, el equipo aprende a ignorar las notificaciones, y el valor se pierde sin que nadie se dé cuenta.
3. Cuando la herramienta señaló una anomalía que resultó ser síntoma de una causa más profunda, ¿alguien escribió qué había pasado? La memoria organizacional de los incidents suele ser más pobre que la memoria de la herramienta. Un runbook post-mortem que conecta «la alerta X era en realidad el síntoma de la cadena Y» vale, a medio plazo, más que una actualización del tier de la herramienta.
4. Si la herramienta mostrara métricas en verde durante seis semanas consecutivas, ¿qué controlarías de todos modos? Es la pregunta que un médico de familia experimentado haría a un paciente con todos los análisis en rango pero con fatiga persistente. Un sistema puede tener todos los gráficos en verde y estar preparando el colapso: una cola silenciosa de sesiones en wait sobre una estructura de lock, una tabla que crece fuera de modelo, un procedimiento que entra en bucle cada primer lunes del mes y se resuelve antes del umbral de alerta. El verde es una buena noticia, no una garantía.
Lo que el board pregunta de verdad #
La pregunta del board — «¿por qué la herramienta no nos avisó?» — esconde casi siempre otra pregunta, más incómoda de formular explícitamente: «¿quién, aquí dentro, está leyendo el sistema en su conjunto, más allá de su propia parte?». Cuando la respuesta es «de forma estructurada, nadie», la herramienta se convierte en lo más sencillo de señalar como insuficiente. Es comprensible, y es también una buena oportunidad de conversación — porque la respuesta real no es «contratemos una herramienta más inteligente», sino «asegurémonos de que alguien, con el tiempo y el mandato necesarios, esté leyendo las herramientas que ya tenemos con el cuadro completo en mente».
Esa persona puede ser interna — un senior con el perímetro adecuado, protegido del ruido operativo, con autoridad para hablar al board cuando sea necesario. Puede estar apoyada desde fuera de forma continuada, como contrapunto independiente. En algunos momentos — una reconstrucción post-incident, una duda sobre un presupuesto de plataforma — puede venir de fuera de forma puntual, con un mandato preciso y acotado. Ninguno de estos tres caminos requiere sustituir la herramienta de observability: los tres la hacen finalmente útil por lo que es, un aliado diagnóstico que necesita un lector competente.
Una pregunta para llevarse #
No hay un principio universal sobre la observability. Hay, para cada organización que tiene una madura, una pregunta que vale la pena plantear en el próximo post-mortem:
«La herramienta mostró en tiempo real lo que ocurrió — y en las dos semanas anteriores alguien había leído esos gráficos con un modelo causal en mente, o cada uno miraba su propia parte?»
Si la respuesta tiene alguna vacilación, la próxima vez que el board pregunte «¿pero no habíamos contratado Datadog?», la conversación será más sencilla de mantener — porque la respuesta no girará en torno al vendor, sino a lo que hemos aprendido a leer mientras tanto.
Ivan Luminaria es Technical Leader para bases de datos mission-critical. Trabaja con CIO, CTO y IT Director de bancos mid-tier, aseguradoras, telcos, utilities y grandes administraciones públicas italianas con un método de lectura cross-layer construido en casi treinta años de sistemas reales.