- Ivan Luminaria/
- Database Strategy/
- MySQL/
- 128 MB en una máquina de 32 GB: el buffer pool de InnoDB que nadie había tocado/
128 MB en una máquina de 32 GB: el buffer pool de InnoDB que nadie había tocado
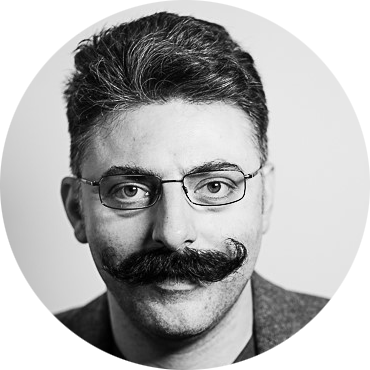
128 MB en una máquina de 32 GB #
La alerta llegó un jueves por la mañana: latencia media de las queries en aumento, picos por encima de los 100ms en operaciones que en teoría deberían ser rápidas. Una aplicación de e-commerce, MySQL 8.0, servidor con 32 GB de RAM. El equipo ya había revisado los índices, ya había repasado las queries más lentas, ya había añadido algún EXPLAIN. Todo parecía razonable sobre el papel.
Entonces alguien miró innodb_buffer_pool_size.
128 MB. El valor por defecto. En una máquina con 32 GB de RAM disponibles, MySQL estaba usando 128 MB como caché para los datos de InnoDB. El 95% de las lecturas terminaba en disco. El hit ratio del buffer pool estaba por debajo del 50%.
No era un problema de queries. Era un problema de configuración básica que nadie había tocado desde el aprovisionamiento inicial.
Lo que hace el buffer pool, de verdad #
El buffer pool es la estructura de memoria central de InnoDB. Cuando MySQL lee una página de disco — ya sea una fila de una tabla, un nodo de un índice B-tree, o datos de undo — la carga en memoria en el buffer pool. Las lecturas posteriores de esa misma página se sirven desde RAM, no desde disco. Cuando se escribe, InnoDB modifica primero la página en memoria (página “dirty”) y luego la sincroniza en disco en segundo plano mediante el mecanismo de flush.
La estructura interna usa una variante del algoritmo LRU (Least Recently Used): las páginas accedidas más recientemente permanecen en la cima, las menos usadas se desalojan para dejar espacio a las nuevas. InnoDB implementa una versión de dos zonas — una “young list” para las páginas accedidas recientemente y una “old list” para las candidatas al desalojo — para evitar que los full scan de tablas grandes expulsen de la caché las páginas calientes [1].
Las páginas dirty las escribe en disco el hilo de flush en segundo plano. El parámetro innodb_io_capacity controla cuántas operaciones de I/O por segundo puede usar InnoDB para este propósito. Si el buffer pool es demasiado pequeño, la tasa de desalojo es alta, las páginas dirty se flushean continuamente, y el disco se convierte en el cuello de botella incluso con hardware rápido.
Con 128 MB de buffer pool y tablas que en conjunto ocupan varios GB, cualquier query que toque datos no recientes termina en disco. En un e-commerce con patrones de acceso distribuidos entre catálogo de productos, pedidos y sesiones de usuario, el resultado es exactamente lo que el equipo estaba viendo: latencia alta, I/O saturado, CPU relativamente tranquila.
La regla del 70-80% — y cuándo no aplicarla #
La recomendación estándar para un servidor dedicado a MySQL es asignar al buffer pool entre el 70% y el 80% de la RAM disponible [2]. En 32 GB, eso significa entre 22 y 26 GB. En el caso en cuestión, llegamos a 24 GB — aproximadamente el 75%.
-- Verifica el valor actual
SHOW VARIABLES LIKE 'innodb_buffer_pool_size';

-- Modificación en tiempo de ejecución (MySQL 5.7.5+, InnoDB dynamic resize)
SET GLOBAL innodb_buffer_pool_size = 25769803776; -- 24 GB en bytes
A partir de MySQL 5.7.5, el redimensionado del buffer pool ocurre online sin reinicio, aunque la operación no es instantánea: InnoDB redimensiona el pool por chunks, y durante el proceso hay un ligero impacto en el rendimiento. Vale la pena hacerlo en una ventana de baja actividad la primera vez; después, el valor va en el fichero de configuración.
# /etc/mysql/mysql.conf.d/mysqld.cnf
[mysqld]
innodb_buffer_pool_size = 24G
La regla del 70-80% aplica a servidores dedicados. Si la máquina aloja también la aplicación, un servidor web u otros procesos con footprint de memoria significativo, hay que bajar ese porcentaje. Un sistema que entra en swap por culpa del buffer pool es peor que un buffer pool pequeño: el swap en disco es mucho más lento que cualquier I/O de base de datos normal.
Buffer pool instances: la contención en los mutex #
Con un buffer pool grande, entra en juego un segundo parámetro: innodb_buffer_pool_instances.
El buffer pool está protegido por mutex internos. En sistemas con muchos hilos concurrentes, un único pool grande se convierte en un cuello de botella por la contención sobre estos locks. La solución es dividir el pool en instancias independientes, cada una con su propio conjunto de mutex y su propia LRU list [3].
La regla práctica: una instancia por cada GB de buffer pool, hasta un máximo de 64. Para 24 GB, 8 instancias es un punto de partida razonable.
[mysqld]
innodb_buffer_pool_size = 24G
innodb_buffer_pool_instances = 8
Un detalle importante: innodb_buffer_pool_instances solo tiene efecto si innodb_buffer_pool_size es de al menos 1 GB. Con los 128 MB por defecto, el parámetro se ignora. Es otro motivo por el que el problema era invisible hasta que alguien miraba la configuración de base.
En workloads con alta concurrencia — y un e-commerce con picos de tráfico lo es — la diferencia entre una y ocho instancias puede ser medible incluso después de resolver el problema principal de dimensionado.
Leer las señales: hit ratio y páginas dirty #
Antes de tocar cualquier parámetro, el punto de partida es entender qué está pasando. SHOW ENGINE INNODB STATUS es el comando que cuenta la vida interna de InnoDB en un momento dado [4].
SHOW ENGINE INNODB STATUS\G
La salida es verbosa. La sección relevante para el buffer pool es BUFFER POOL AND MEMORY:
----------------------
BUFFER POOL AND MEMORY
----------------------
Total large memory allocated 137363456
Dictionary memory allocated 409606
Buffer pool size   8192
Free buffers       1024
Database pages     7168
Old database pages 2624
Modified db pages  512
Pending reads      0
Pending writes: LRU 0, flush list 0, single page 0
Pages made young 1847392, not young 284719
0.00 youngs/s, 0.00 non-youngs/s
Pages read 9284719, created 48291, written 284719
0.00 reads/s, 0.00 creates/s, 0.00 writes/s
Buffer pool hit rate 501 / 1000, young-making rate 0 / 1000 not 0 / 1000
La línea clave es Buffer pool hit rate. En el formato X / 1000, un valor de 501 significa un hit ratio del 50,1% — de cada dos lecturas, una va a disco. El objetivo en producción es mantenerse por encima de 990/1000, idealmente 995+.
Para un monitoreo más granular, las tablas de performance_schema e information_schema exponen métricas por instancia:
SELECT
  pool_id,
  pool_size,
  free_buffers,
  database_pages,
  hit_rate,
  pages_made_young,
  pages_not_made_young
FROM information_schema.INNODB_BUFFER_POOL_STATS;
Las Modified db pages (páginas dirty) merecen atención: un número alto y estable indica que el flush no consigue seguir el ritmo de las escrituras. Si sube progresivamente, es una señal de que innodb_io_capacity hay que revisarlo en relación con el hardware disponible.
El restart y el problema del cold start #
Hay un aspecto del buffer pool que a menudo se ignora hasta el primer reinicio en producción: después de un reinicio, el pool está vacío. Todas las páginas calientes que estaban en memoria se pierden. El sistema arranca frío, y durante un período variable — de minutos a horas, según el workload y el tamaño del pool — el rendimiento está degradado mientras InnoDB recarga progresivamente los datos desde disco.
MySQL ofrece un mecanismo para mitigar esto: el dump y el restore del buffer pool [5].
[mysqld]
# Guarda el buffer pool al apagar
innodb_buffer_pool_dump_at_shutdown = ON

# Porcentaje de páginas a guardar (por defecto 25)
innodb_buffer_pool_dump_pct = 25

# Carga el buffer pool al arrancar
innodb_buffer_pool_load_at_startup = ON
Con innodb_buffer_pool_dump_at_shutdown = ON, MySQL guarda en un fichero (por defecto ib_buffer_pool en la datadir) los identificadores de las páginas que estaban en el pool en el momento del apagado. En el siguiente arranque, con innodb_buffer_pool_load_at_startup = ON, las páginas se recargan en segundo plano.
El fichero contiene solo los identificadores (tablespace ID y page number), no los datos: el restore requiere que MySQL vuelva a leer las páginas desde disco, pero lo hace de forma organizada y prioritaria, reduciendo significativamente el tiempo de warm-up.
También es posible forzar el dump y el restore en tiempo de ejecución, sin esperar a un apagado:
-- Dump manual del buffer pool
SET GLOBAL innodb_buffer_pool_dump_now = ON;

-- Restore manual (útil tras un reinicio no planificado)
SET GLOBAL innodb_buffer_pool_load_now = ON;

-- Monitorear el progreso del restore
SHOW STATUS LIKE 'Innodb_buffer_pool_load_status';
En el caso analizado, después de configurar el dump automático y hacer un reinicio controlado para aplicar los nuevos parámetros, el warm-up duró aproximadamente 8 minutos en lugar de los 40-50 que se esperaban con un pool de 24 GB completamente frío. No es magia: es que el 25% de las páginas más calientes cubre la gran mayoría de los accesos reales.
Los números, antes y después #
La comparación es clara:
| Métrica | Antes | Después |
|---|---|---|
innodb_buffer_pool_size | 128 MB | 24 GB |
innodb_buffer_pool_instances | 1 | 8 |
| Hit ratio | ~50% | ~997/1000 |
| Lecturas desde disco | ~95% | <1% |
| Latencia media de queries | 45ms | 3ms |
| Throughput (queries/s) | baseline | ~2× |
La latencia de 45ms a 3ms no es el resultado de una query reescrita ni de un índice añadido. Es el resultado de dejar de leer desde disco lo que podía estar en RAM. El disco era el cuello de botella, y ese cuello de botella estaba ahí desde el día del aprovisionamiento.
El throughput duplicado es una consecuencia directa: menos espera en I/O significa más queries servidas en el mismo tiempo, con la misma CPU.
Lo que conviene no olvidar #
El buffer pool no es el único parámetro que importa en MySQL, pero probablemente es el que tiene la relación impacto/complejidad más alta. Un servidor con 32 GB de RAM y 128 MB de buffer pool es como un almacén con 32 habitaciones que usa solo una para guardar la mercancía: el trabajo se hace igual, pero con costes enormemente más altos.
La cuestión no es que el valor por defecto sea incorrecto en términos absolutos — 128 MB tiene sentido en una máquina compartida con poca RAM o en un entorno de desarrollo. La cuestión es que ese valor por defecto nunca se revisa en el momento del aprovisionamiento en producción, y nadie se da cuenta hasta que el sistema empieza a sufrir.
El diagnóstico siempre parte del hit ratio. Si está por debajo de 990/1000, el buffer pool es el primer lugar donde mirar. Después vienen las instancias, después el warm-up, después todo lo demás.
El equipo también configuró una alerta sobre el hit ratio: por debajo de 985/1000 durante más de cinco minutos, salta una notificación. No porque se espere volver al problema anterior, sino porque los sistemas cambian — crecen los datos, cambian los patrones de acceso, llega un módulo nuevo — y conviene saberlo antes de que la latencia vuelva a los 45ms.
Fuentes oficiales #
- MySQL 8.0 Reference Manual — Making the Buffer Pool Scan Resistant
- MySQL 8.0 Reference Manual — Configuring InnoDB Buffer Pool Size
- MySQL 8.0 Reference Manual — Configuring Multiple Buffer Pool Instances
- MySQL 8.0 Reference Manual — SHOW ENGINE INNODB STATUS
- MySQL 8.0 Reference Manual — Saving and Restoring the Buffer Pool State
Glosario #
InnoDB buffer pool — Área de memoria principal de InnoDB donde se cachean páginas de datos e índices. Cuanto mayor es, menos lecturas terminan en disco. Parámetro:
innodb_buffer_pool_size.Hit ratio (buffer pool) — Porcentaje de lecturas servidas desde memoria respecto al total. Se expresa en formato X/1000 en la salida de
SHOW ENGINE INNODB STATUS. Valores por debajo de 990/1000 indican dependencia excesiva del disco.Página dirty — Página del buffer pool modificada en memoria pero aún no sincronizada en disco. InnoDB las gestiona mediante flush en segundo plano; un número elevado y creciente indica que el flush no consigue seguir el ritmo de las escrituras.
LRU list (InnoDB) — Estructura de dos zonas (young list + old list) que usa InnoDB para decidir qué páginas mantener en caché y cuáles eliminar. Protege las páginas calientes del desalojo causado por full scans ocasionales.
Buffer pool warm-up — Proceso de recarga de las páginas calientes en el buffer pool tras un reinicio. Con
innodb_buffer_pool_dump_at_shutdowneinnodb_buffer_pool_load_at_startup, MySQL guarda y restaura los identificadores de las páginas, reduciendo el tiempo de cold start de horas a minutos.