- Ivan Luminaria/
- Database Strategy/
- MySQL/
- La llamada de las 8 y 40: recovery de un Galera Cluster con dos nodos caídos/
La llamada de las 8 y 40: recovery de un Galera Cluster con dos nodos caídos
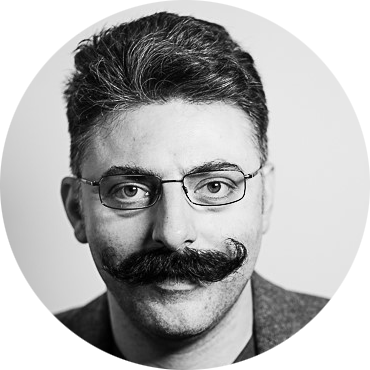
La llamada de las 8 y 40 #
Era temprano por la mañana. Estaba terminando el primer café cuando sonó el teléfono: un colega en visita a un cliente, con la voz algo tensa. Me cuenta que el sistema de monitorización acaba de disparar dos alertas en secuencia sobre un cluster Galera de tres nodos. Me lee el primer ticket:
Cluster Galera, uno de los nodos está fuera. Valor detectado: 2. Nodo que generó la alerta:
mysql-node-01.
wsrep_cluster_size = 2. Un nodo fuera. Le digo que no es una emergencia inmediata — el cluster sigue operativo con dos nodos de tres, el quórum aguanta. “Abre una consola en el nodo que ha alertado y vemos qué ha pasado”, le sugiero. Pero mientras se estaba conectando por SSH, llega el segundo ticket:
Cluster Galera, uno de los nodos está fuera. Valor detectado: 2. Nodo que generó la alerta:
mysql-node-02.
Dos tickets, casi en secuencia. El segundo llegaba desde un nodo distinto, pero seguía reportando 2 como valor — lo que significaba que el cluster, desde el punto de vista de mysql-node-02, todavía tenía dos miembros. “Ok, ahora la cosa cambia”, le digo. “¿Cuál de los dos había quedado? ¿El nodo que disparó la primera alerta ya estaba fuera cuando llegó la segunda, o no?”.
Este artículo es la continuación natural del que trata la configuración de un Galera Cluster a 3 nodos [artículo #33]. Ese explica cómo se construye. Este cuenta qué pasa el día en que los nodos empiezan a caer uno tras otro — y cómo se vuelve a la operatividad, quizás mientras guías a un colega por teléfono con el cliente mirando por encima del hombro.
Cómo el cluster cuenta sus miembros (y por qué ese número lo es todo) #
Antes de pasarle los comandos a ejecutar, le pedí treinta segundos para recordarle el mecanismo que estaba generando esas alertas — porque en el pánico es fácil mirar los números sin leerlos de verdad.
Galera mantiene internamente el concepto de Primary Component (PC): el subconjunto de nodos que tiene el quórum y puede seguir procesando escrituras. Cuando un nodo sale, los demás se ponen de acuerdo sobre quién forma parte del PC mediante el protocolo de membership. La variable que expone este estado es wsrep_cluster_size [1]:
SHOW GLOBAL STATUS LIKE 'wsrep_cluster_size';
SHOW GLOBAL STATUS LIKE 'wsrep_cluster_status';
SHOW GLOBAL STATUS LIKE 'wsrep_local_state_comment';
En un cluster sano de 3 nodos, wsrep_cluster_size vale 3 en todos los nodos y wsrep_cluster_status reporta Primary. Cuando un nodo sale, los dos restantes ven wsrep_cluster_size = 2 — pero siguen operando porque aún tienen quórum (2 de 3 > 50%).
El problema se vuelve crítico cuando salen dos nodos de tres. El nodo restante no tiene quórum: no puede saber si es él quien está aislado o si son los otros dos los que tienen problemas. Para evitar el split-brain — dos particiones que aceptan escrituras divergentes — Galera aplica una regla simple: sin quórum, ninguna escritura. El nodo superviviente pasa a estado non-Primary y deja de aceptar DML.
La monitorización del cliente estaba configurada para alertar sobre wsrep_cluster_size < 3. Correcto. Pero las dos alertas casi simultáneas sugerían un escenario más complejo que un simple nodo reiniciado — y quería que el colega llegara a esa conclusión antes de teclear cualquier comando invasivo.
Diagnóstico: entender qué había pasado de verdad #
“Lo primero que hacemos es construir un mapa temporal”, le digo. “¿Quién salió primero? ¿En qué estado están los nodos ahora? Ve al tercer nodo, el que no ha disparado ninguna alerta.”
En el tercer nodo (mysql-node-03, el silencioso) le hago lanzar:
SHOW GLOBAL STATUS LIKE 'wsrep%';
Me lee la salida relevante:
wsrep_cluster_size          | 1
wsrep_cluster_status        | non-Primary
wsrep_local_state_comment   | Initialized
wsrep_connected             | ON
wsrep_ready                 | OFF
“Ok, mala cosa”, comento. wsrep_cluster_size = 1 y wsrep_cluster_status = non-Primary. El nodo seguía en pie, conectado a la red, pero no aceptaba escrituras. Había perdido el quórum.
Le pido que intente conectarse a los otros dos. En mysql-node-01 y mysql-node-02 MySQL no responde — ambos caídos. Le hago abrir el error log de mysql-node-01 y me lee:
[ERROR] WSREP: gcs/src/gcs_group.cpp:gcs_group_handle_join_msg():736:
  Member 1 (mysql-node-02) requested state transfer from '*any*'.
[Warning] WSREP: Member 1 (mysql-node-02) is waiting for SST from donor.
[ERROR] WSREP: Process completed with error: wsrep_sst_xtrabackup-v2 ...
[ERROR] WSREP: SST failed: 32 (Broken pipe)
“Aquí está la secuencia”, le explico. mysql-node-01 había salido primero (probablemente por un problema de red o OOM), mysql-node-02 había intentado reincorporarse al cluster mediante SST (State Snapshot Transfer), el SST había fallado, y mientras tanto mysql-node-02 también había caído. El nodo restante, mysql-node-03, se había quedado solo y había perdido el quórum.
Las causas más comunes que conviene descartar #
“Antes de proceder al recovery, entendamos por qué sale un nodo”, le digo. No hace falta para el fix inmediato, pero sí para no encontrarnos en la misma situación dos horas después. Las causas más frecuentes en producción:
- Problemas de red: latencia alta o packet loss entre nodos. Galera usa
evs.suspect_timeoutyevs.inactive_timeoutpara decidir cuándo expulsar un nodo. Un nodo lento en responder se expulsa aunque MySQL esté sano. - OOM killer: el kernel Linux termina
mysqldpor presión de memoria. Se ve endmesgo/var/log/messages. - Slow applier: el nodo no consigue seguir el ritmo del flujo de writesets. Un valor alto de
wsrep_local_recv_queue_avges una señal clara. - gcache overflow: si el nodo ha estado offline el tiempo suficiente como para no encontrar los writesets necesarios en el gcache de los otros nodos, no puede hacer IST y tiene que hacer SST — mucho más costoso.
Le hago mirar dmesg en mysql-node-01. Tarda diez segundos: Out of memory: Kill process [mysqld] unos 20 minutos antes de la primera alerta. OOM killer, candidato principal. Me lo anoto mentalmente para después — primero recuperamos el cluster.
SST e IST: reincorporarse al cluster no es lo mismo en ambos casos #
“Ahora te explico por qué falló el SST, para que entiendas qué tenemos que evitar cuando hagamos reentrar los nodos”, le digo.
Cuando un nodo se reincorpora tras una ausencia, Galera necesita sincronizarlo con el estado actual del cluster. Hay dos modalidades [2]:
IST (Incremental State Transfer): el nodo recibe solo los writesets que se ha perdido, desde el gcache de los otros nodos. Es rápido, no interrumpe al donor, no requiere un backup completo. Funciona solo si el gap es pequeño y los writesets necesarios siguen en el gcache.
SST (State Snapshot Transfer): transferencia completa del estado — esencialmente un backup físico (con xtrabackup, mysqldump o rsync) desde el donor al joiner. Es lento, puede poner bajo presión al donor, y durante el SST el donor puede volverse no-responsivo para las lecturas (depende del método). Es necesario cuando el gap es demasiado grande para IST.
La distinción práctica: si un nodo ha estado offline unos pocos minutos y el gcache está dimensionado correctamente (wsrep_provider_options = "gcache.size=2G" como punto de partida), IST está casi garantizado. Si el nodo ha estado offline horas o días, SST es inevitable.
“En vuestro caso”, le digo, “el SST fallido es el punto crítico”. mysql-node-02 había intentado reincorporarse, el donor había iniciado la transferencia, pero algo había interrumpido el proceso (el Broken pipe en el log apuntaba a un problema de conexión durante la transferencia). Y mientras tanto mysql-node-02 había quedado en un estado inconsistente — ni dentro ni fuera.
El procedimiento de recovery: orden y paciencia #
“Ok, ahora recomponemos. Con dos nodos caídos y uno en non-Primary, el orden importa más que cualquier otra cosa. No toques nada antes de que te lo diga.”
Paso 1: identificar el nodo más actualizado #
Antes de hacer reentrar cualquier nodo, hay que saber cuál tiene la secuencia de transacciones más avanzada. Ese será el donor para los demás.
“Ve a cada nodo, incluso los que tienen MySQL caído, y léeme el fichero de estado de Galera”:
cat /var/lib/mysql/grastate.dat
Salida típica:
# GALERA saved state
version: 2.1
uuid:    6b3f8c2a-1234-11ee-abcd-0242ac110003
seqno:   847392
safe_to_bootstrap: 0
El nodo con seqno más alto es el más actualizado. Si safe_to_bootstrap: 1, el propio Galera ya ha identificado ese nodo como seguro para el bootstrap. Si todos los nodos muestran safe_to_bootstrap: 0 (escenario habitual tras un crash simultáneo), hay que elegir manualmente el nodo con seqno más alto y modificar el fichero.
Paso 2: bootstrap del nodo más actualizado #
“Ahora viene la parte delicada, así que sígueme paso a paso y sin prisas.” El bootstrap de emergencia es el momento más crítico: se trata de arrancar el primer nodo como nuevo Primary Component, sin esperar a los demás.
# En el nodo con seqno más alto, modificar grastate.dat
# Establecer safe_to_bootstrap: 1

# Luego arrancar con --wsrep-new-cluster
galera_new_cluster
# o bien, según la distribución:
mysqld_safe --wsrep-new-cluster &
Esto crea un nuevo cluster con un único miembro. El nodo se convierte en Primary y empieza a aceptar escrituras. Atención: si se hace bootstrap en el nodo equivocado (el de seqno más bajo), se pierden las transacciones que ya habían sido confirmadas en el nodo más avanzado. “Tómate dos minutos más y verifica los seqno de los tres nodos antes de elegir. Mejor dos minutos ahora que un rollback complicado después.”
Me relee los valores: mysql-node-03 (el único que seguía en pie) tenía seqno: 847392, mientras que mysql-node-01 mostraba seqno: 847389. “Bien, el bootstrap hay que hacerlo en mysql-node-03.”
Paso 3: reincorporar los nodos uno a uno #
“Espera a que el primer nodo esté en Primary, luego arrancamos el segundo. Uno a uno, sin excepciones.” Se arrancan de forma normal (sin --wsrep-new-cluster) y Galera gestiona la sincronización:
systemctl start mysql
El nodo que se reincorpora se conecta al cluster, negocia IST o SST, y se sincroniza. Durante esta fase, le hago mantener abierto un bucle de control sobre:
SHOW GLOBAL STATUS LIKE 'wsrep_local_state_comment';
-- Progresión esperada: Joining -> Waiting for SST -> Joined -> Synced
“Espera a Synced antes de tocar el tercer nodo. Si los arrancas todos a la vez aumentas la carga sobre el donor y arriesgamos otro SST fallido — y en ese caso volvemos a empezar desde cero.”
Paso a paso, con el colega al teléfono #
A partir de ese momento la llamada se volvió operativa. Yo le dictaba los comandos, él los ejecutaba y me leía la salida. Fue así:
- Verificado
grastate.daten los tres nodos.mysql-node-03tenía el seqno más alto y ya estaba en pie (en estadonon-Primary). - Reiniciado
mysql-node-03congalera_new_clusterdespués de establecersafe_to_bootstrap: 1en sugrastate.dat. El nodo pasó enseguida aPrimaryconwsrep_cluster_size = 1. “Bien, respiremos un momento.” - Arrancado
mysql-node-01. Negoció IST (el gap era de unos pocos miles de writesets, el gcache era suficiente). Sincronizado en unos 3 minutos. El colega me leeSyncedy noto que se relaja un poco. - Arrancado
mysql-node-02. También IST, sincronizado en 4 minutos. - Verificado en los tres nodos:
wsrep_cluster_size = 3,wsrep_cluster_status = Primary,wsrep_local_state_comment = Synced.
El cluster había vuelto a ser operativo. El downtime efectivo para las escrituras había sido de unos 35 minutos — el tiempo entre la caída del segundo nodo y la finalización del bootstrap. El colega cierra la llamada con un “gracias, ahora voy a explicarle al cliente qué ha pasado”. El mérito principal, le digo antes de colgar, es que mantuvo la cabeza fría y no tocó nada antes de entender la situación.
Lo que queda por hacer después del recovery #
El recovery es la parte visible. La parte que más importa es lo que se hace después, cuando la presión ha bajado. Por la tarde hice una segunda ronda de llamada con el colega para dejar por escrito lo que valía la pena corregir.
Sobre la monitorización: la alerta sobre wsrep_cluster_size < 3 era correcta, pero faltaba una alerta sobre wsrep_cluster_status != Primary. Son dos condiciones distintas: un cluster puede tener cluster_size = 2 y seguir siendo Primary (un nodo ha salido pero el quórum aguanta), o tener cluster_size = 1 y ser non-Primary (ninguna escritura posible). El segundo escenario requiere intervención inmediata; el primero tiene más margen.
Sobre el gcache: dimensionar el gcache de modo que IST sea posible para ausencias breves. Un gcache de 512MB en un cluster con alto throughput de escritura se agota en pocos minutos. Aumentarlo a 2-4GB reduce drásticamente la necesidad de SST en reinicios rápidos.
Sobre el OOM: el problema original era el OOM killer en mysql-node-01. La solución no estaba en el cluster Galera — estaba en la configuración de memoria de MySQL (innodb_buffer_pool_size demasiado agresivo para la RAM disponible) y en la ausencia de swap. Dos cosas que no tienen nada que ver con la replicación, pero que en un cluster HA se vuelven críticas porque el crash de un proceso se propaga como evento de membership.
Sobre el bootstrap: documentar el procedimiento de bootstrap de emergencia en el runbook operativo, con los comandos exactos y el orden correcto. Es un procedimiento que se hace raramente, bajo presión, con el cliente pidiendo actualizaciones cada cinco minutos. No es el momento de intentar recordarlo de memoria — ni de tener que llamar a un colega porque no te acuerdas.
El runbook que habríamos querido tener esa mañana #
Esta es la versión sintética del procedimiento, para tener a mano — la que el colega se guardó en un fichero en el repositorio del cliente antes de cerrar la jornada:
# 1. Verificar estado en todos los nodos
mysql -e "SHOW GLOBAL STATUS LIKE 'wsrep%';" 2>/dev/null || echo "MySQL down"

# 2. Leer seqno desde grastate.dat (aunque MySQL esté caído)
cat /var/lib/mysql/grastate.dat

# 3. En el nodo con seqno más alto: habilitar bootstrap
sed -i 's/safe_to_bootstrap: 0/safe_to_bootstrap: 1/' /var/lib/mysql/grastate.dat

# 4. Bootstrap del primer nodo
galera_new_cluster

# 5. Verificar que esté en Primary
mysql -e "SHOW GLOBAL STATUS LIKE 'wsrep_cluster_status';"

# 6. Arrancar los demás nodos uno a uno
systemctl start mysql
# Esperar Synced antes del siguiente

# 7. Verificación final en todos los nodos
mysql -e "SHOW GLOBAL STATUS LIKE 'wsrep_cluster_size'; SHOW GLOBAL STATUS LIKE 'wsrep_cluster_status';"
Simple sobre el papel. Menos simple cuando estás en casa de un cliente, tienes el segundo ticket en el monitor y estás esperando que alguien al otro lado del teléfono te diga por dónde empezar.
Fuentes oficiales #
- Codership — Galera Cluster Documentation: wsrep Status Variables <TODO: scout URL específico para wsrep_cluster_size>
- Percona Documentation — State Snapshot Transfer (SST) and Incremental State Transfer (IST)
- Codership — Galera Cluster Recovery <TODO: scout URL específico para bootstrap de emergencia>
- Percona Blog — gcache sizing <TODO: scout URL actualizado>
Glosario #
Primary Component (PC) (Galera) — El subconjunto de nodos que posee el quórum y puede seguir procesando escrituras. Un nodo fuera del PC pasa a estado
non-Primaryy deja de aceptar DML para evitar split-brain.wsrep_cluster_size (Galera) — Variable de estado que reporta el número de nodos actualmente en el cluster Galera. Valor esperado en un cluster de 3 nodos:
3. Caer por debajo del umbral de quórum (≤ 1 de 3) bloquea las escrituras.IST (Incremental State Transfer) (Galera) — Sincronización incremental de un nodo que se reincorpora al cluster: recibe solo los writesets que le faltan desde el gcache de los otros nodos. Rápido y no invasivo para el donor; posible solo si el gap está cubierto por el gcache.
SST (State Snapshot Transfer) (Galera) — Transferencia completa del estado desde un nodo donor a un joiner: equivale a un backup físico completo. Necesario cuando el gap es demasiado grande para IST. Puede ralentizar al donor durante la transferencia.
gcache (Galera) — Buffer circular en disco que cada nodo Galera mantiene para conservar los writesets recientes. Dimensionar correctamente el gcache (
gcache.size) es la principal palanca para favorecer IST frente a SST en reinicios breves.